在正式开始讲解 OC 对象前,我们需要弄清楚一些前置策略
即文章的标题,
对象的本质是什么,形态是什么,类型策略是什么,身份观是什么
这些词很抽象,但是并不复杂,
我们来一个一个看看
本体论
对象到底是什么
OC中,对象的本质是什么?
那我们先来看Objective-C语言的本质
OC语言的底层(运行时 Runtime)实际上是用 C / C++ 来实现的
我们写的 OC 代码会被编译器直接编译成汇编代码
汇编代码最后转换成机器语言,即 0 和 1
所以 OC 的面向对象,本质都是靠 C / C++ 实现的数据结构和函数来支撑的
OC对象底层使用的是C 和 C++的结构体来实现的
我们可以使用指令来重写代码:
xcrun -sdk iphoneos clang -arch arm64 -rewrite-objc main.m -o main-arm64.cpp当然这只是理论上的「观察手段」——这里要澄清一点:clang 并不会真的把 OC 先翻译成 C / C++ 再编译,真实路径是 OC 源码 → Clang AST → LLVM IR → 机器码,中间并没有 C / C++ 这一层。-rewrite-objc 只是一个独立的工具,它把 OC 改写成等价的 C / C++,让我们「看见」运行时究竟把对象实现成了什么结构,仅供理解之用
新版中,Apple为了安全,并且认为应该没人有重写的需求,在新版clang里废弃了这个指令,你只能通过旧版的LLVM来重写
这个时候问题又来了,一些新的写法LLVM完全无法识别,所以还是编译不了...
我验证了三个版本:
- LLVM 22(最新):已完全移除RewriteObjC,报错无法使用
- LLVM 15:保留RewriteObjC,但不认识新 SDK 里的Vision OS等类型
- LLVM 17:两者兼顾,是目前最适合的版本(当前版本为26.4.1,日期为 2026 年 4 月 20 日)
这边建议各位程序员师傅让 AI 写一个 .sh 脚本,方便编译转写
我在最后也会把我的 .sh 放在上边供各位参考
转写之后得到一个两万行左右的文件: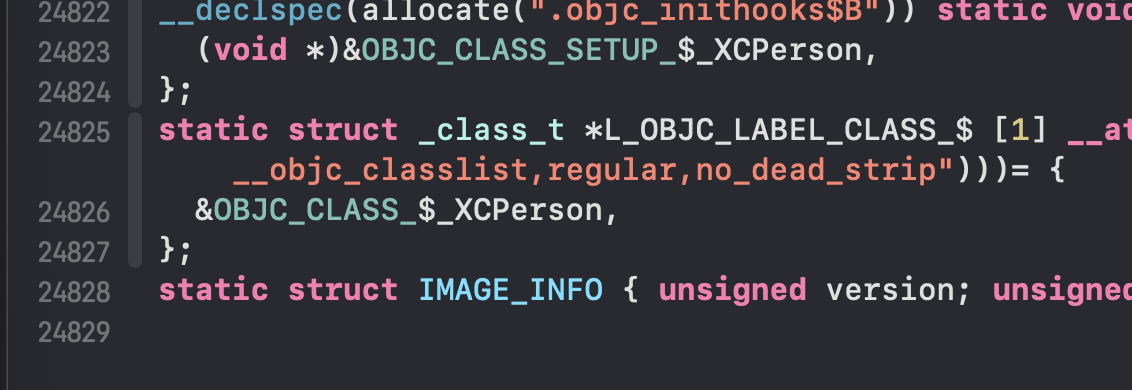
在Xcode中搜索main,找到转写后的main函数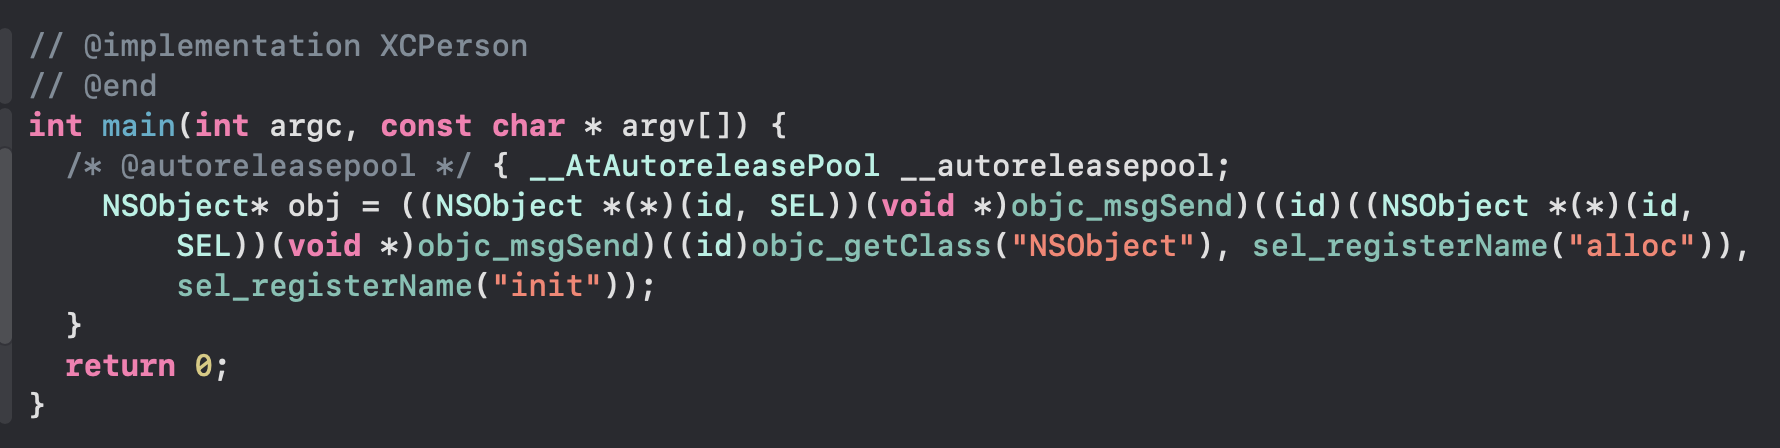
还是看不出什么...
在改写文件里搜索NSObject_IMPL,找到结构体:
struct NSObject_IMPL {
__unsafe_unretained Class isa;
};
从名称上看,即可知道,这个结构体即为NSObject的实现,即implementation
也就是说,一个NSObject对象,在内存中是这个结构体
从这里我们可以看出来OC的对象实际上就是结构体,或者说OC面向对象的部分是由C / C++ 中的结构体来实现的
你也可以按住command进入底层,查看NSObject的声明:
@interface NSObject <NSObject> {
#pragma clang diagnostic push
#pragma clang diagnostic ignored "-Wobjc-interface-ivars"
Class isa  OBJC_ISA_AVAILABILITY;
#pragma clang diagnostic pop
}
其实实际上也是一个isa
相当于一个NSObject对象,实际上就是这个结构体,这个结构体里只有一个成员变量:isa
这个isa是什么东西呢,为什么是class类型,点击继续深入查看
可以看到:
typedef struct objc_class *Class;可以看到这个东西就是一个指针
那么既然isa是一个指针,那在 64 位环境下,它占用为 8 字节,即理论上应该结构体应该占用 8 字节
我们先当他为 8 字节,重新回到之前的代码
NSObject* obj = [[NSObject alloc] init];我们可以发现,在对象空间创建完毕,即结构体创建完毕后,应该把该结构体的地址赋值给obj
由于结构体内只有这么一个成员,所以对象的地址实际上就是isa在内存中的地址
isa指针是什么在这里我们不多赘述,在之后会详细讲解其结构等内容
这里我们只需要知道isa指针是一个对象的身份证,负责把静态数据和动态行为相连接即可
总结一下
在OC这门语言中,对象的本质就是一个结构体,结构体内具备一个isa指针,用来告诉外界自己是什么,支持什么方法
在 C 结构体上注入 Smalltalk 灵魂
那这种设计是为什么解决什么呢?
在当时的设计环境中,Brad Cox 和 Tom Love想要软件复用,但是C语言实现不了
实际上如果你有了解过OC语言的两位创始人大神的一些思想和主要成果,会更好的了解他们想解决的问题
Cox 最广为人知的理念是把软件开发推向"工业化",他在 1986 年出版的经典著作《Object-Oriented Programming: An Evolutionary Approach》中,正式提出了"Software IC"(软件集成电路)的概念——主张软件组件应当像硬件芯片一样,可以被独立制造、封装、出售并被重复组装到不同系统中
如果说 Cox 更偏语言哲学与组件经济,Love 则更偏工程管理与组织实践。他长期关注:如何让大团队真正用好面向对象方法、如何度量与提升程序员生产力、以及如何在企业级项目中避免"软件灾难"。
1981 年前后,Cox 与 Love 在 ITT 共同接触到刚刚兴起的 Smalltalk-80。两人都被 Smalltalk 的消息传递机制和动态对象模型深深吸引,但是Smalltalk有几个重大的缺陷:
- 性能:Smalltalk 运行在一个庞大的虚拟机上,开销极高
- 隔离:Smalltalk 的代码库与 C 语言完全隔离,无法复用当时已经积累了数十年的 C 语言生态
在这种情况下,Cox 想到的解决方案是:
不要抛弃 C,而是在 C 的结构体上注入 Smalltalk 的灵魂
具体来说就是我们看到的源码结构,在一个普通的 C 结构体的第一个成员位置放上一个叫做isa的指针,这块冷冰冰的内存就被运行时系统识别为一个有血有肉的"对象"
这个 isa 指针指向类对象,类对象里存放着方法列表、父类信息和内存布局描述,由此构成了整个面向对象大厦的地基
不过这都是后话了,将在第六部分详细讲解
在这个背景下,Cox 主导设计了一种"在 C 语言之上叠加 Smalltalk 风格消息机制"的语言
这种设计方式同时解决了三个问题:
- 对 C 语言的零侵入:任何现有的 C 代码都不需要改动,可以直接在 Objective-C 项目中使用
- 以极低的运行时开销实现面向对象:整个运行时系统本身就是用 C 写的,没有虚拟机,没有字节码解释器
- 让消息传递成为可能:
objc_msgSend通过追踪isa指针在运行时动态查找方法,实现了 Smalltalk 风格的晚期绑定
设计必然牺牲一些东西,这种牺牲随着硬件和软件的更新变得越来越清晰
类型安全的全面缺失
由于OC对象的本质只是一个带有isa的 C 结构体,编译器在静态分析阶段对类型的掌握极其有限。你声明的
NSString *只是一个承诺,而不是一道防护墙。运行时系统只会顺着isa去查方法字典,如果找不到,直接抛出崩溃。编译器无法在你写错代码的那一刻拦截你,只有在用户运行 App 的那一刻才会爆炸
内存布局的不透明与碎片化
因为每个对象都是独立分配在堆内存中的孤岛,当你操作一个包含大量对象的集合时,你实际上是在追逐散落在内存各处的指针现代 CPU 的缓存机制依赖于数据的空间局部性(即相邻内存的数据更可能被连续访问),而这种"堆内存孤岛 + 指针追逐"的模式会导致大量的缓存未命中(Cache
Miss),在数据密集型场景下性能损耗显著运行时的不确定性带来了维护成本
isa指针指向的类对象在运行时是可以被修改的(Method Swizzling、动态添加方法等)。这种极度的动态性是一把双刃剑:它赋予了框架开发者无与伦比的黑魔法能力(如 KVO 的底层实现),
但也让代码的行为变得难以在静态分析工具下预测,增加了大型团队协作时的维护成本和调试难度
自由的代价是永恒的警惕
isa本身的语义过载
随着时间推移,苹果为了极致优化,将isa从一个纯粹的"类指针"改造成了一个塞满了各种信息的位域(Bitfield),即Non-pointer ISA包括引用计数、弱引用标记、析构状态等。
这种设计在性能上极其出色,但它让
isa这个本应只承担"连接静态数据与动态行为"单一职责的指针,变成了一个语义过载的多功能寄存器,增加了运行时实现的复杂度
现代语言如何减少运行时决策
那最新的语言设计是什么样的呢?
我们以swift为例
Swift 并没有完全抛弃 Objective-C 的运行时,但它重新设计了对象的本体论基础。
它引入了两套平行的机制:
对于需要共享状态的实体,Swift 的 class 依然使用堆分配和引用语义,底层依然有类似 isa 的类型元数据指针
但对于纯数据模型,Swift 大力推广 struct 和 enum,它们采用就地内联存储(局部变量通常在栈上,作为类的属性时则内联在对象内部),内存连续,没有 isa 指针的开销,也没有引用计数的负担
更重要的是,Swift 用协议(Protocol)和见证表(Protocol Witness Table)替代了动态消息查找。
当你定义一个遵循协议的类型时,编译器会在编译阶段生成一张静态的函数指针表,运行时直接跳转,无需动态查找。
类型错误在编译时就会被拦截,彻底消灭了"未识别选择器"崩溃的可能性
从 Objective-C 的"C 结构体注入 Smalltalk 灵魂",到 Swift 的"编译期协议约束",
这条演进路线的本质,是编程语言设计者对同一个核心问题不断给出更优解的过程:
如何在不牺牲抽象能力的前提下,让系统在运行时尽可能地少做决策。
形态
堆上的实体,手里的指针
我们之前讲了OC对象的本质是一个结构体
对于形态这一章节来说,我们要讲的是这个对象在物理内存中以何种姿态存在?开发者又是通过什么方式触摸到它?
这一节我们会从最底层的内存模型出发,一步步揭示 Objective-C 为什么强制要求所有对象都必须以"堆分配 + 指针引用"的形态存在
从对象的使用来说
我们一般写的代码都是:
NSObject *obj = [[NSObject alloc] init]; 不难发现,最后我们拿到手里的,只是一个obj的指针
Objective-C 在形态层面做了两个极其严格、不容妥协的规定。这两条规定从语法层面就被强制执行,编译器会无情地拒绝任何试图绕过它们的代码
你无法使用这样的代码:
NSObject obj;即你不能拥有一个真正的对象
编译器会告诉你:Interface type cannot be statically allocated
在 C 语言的世界里,结构体可以自由地分配在栈上或堆上,
开发者拥有完全的选择权
但 Objective-C 直接剥夺了这种选择权。
当你写下 [[NSObject alloc] init] 时,运行时系统会调用底层的 class_createInstance 函数,
最终通过 calloc 在堆内存中分配一块连续的内存空间
这不是一个语法限制这么简单,它的背后是整个语言的设计哲学
真正的对象必须拥有独立于函数调用栈的生命周期
栈内存的本质是"阅后即焚"——函数执行完毕的那一刻,栈帧被弹出,
所有栈上的数据瞬间消失。如果对象被允许放在栈上,它就会被绑死在创建它的那个函数上,无法跨越函数边界共享,更无法被多个对象同时持有
既然真正的对象在堆上,那开发者手中握着的是什么?
是一个指针,是一根风筝线
里面记录的仅仅是对象本体在堆内存中的物理坐标
这就是为什么你声明任何 Objective-C 对象时,都必须在类型后面加上那个不起眼但意义重大的星号
统一指针形态带来的便利与代价
在你知道我们其实一直在用指针后,我们就需要追寻一个更深层次的问题,为什么要这样?
因为所有的对象在开发者手里都是一个八字节的指针,编译器和运行时系统在处理多态的时候获得了极大的便利
无论这个对象类型是什么,他在变量定义,参数传递的时候,都只有 8 字节
这个统一性让一个函数变得很方便:id objc_msgSend(id self, SEL _cmd, ...);
无论你给什么对象发消息,第一个参数永远是一个 id(指向 objc_object 结构体的指针),而这个结构体的第一个成员正是 isa
运行时系统不需要关心这个对象有多大、内部布局如何,它只需要顺着指针找到 isa,然后查方法表即可
由于所有对象都是 8 字节的指针,Objective-C 的应用程序二进制接口(ABI)变得极其简单。
函数调用约定、参数传递、栈帧布局都不需要为不同的对象类型做特殊处理。
这也是为什么 Objective-C 能够无缝地与 C 语言混编——对 C 语言来说,一个 Objective-C 对象本质上就是一个不透明的指针(opaque pointer),它不需要理解对象内部是什么样子
除了这些,引用语义还有一个优点
对象的生命周期不再由任何单一的所有者决定,而是由"还有谁在引用它"这个动态条件决定
这种共享所有权模型为引用计数(Reference Counting)和后来的 ARC(Automatic Reference Counting)铺平了道路
牺牲了什么呢?
首先,对于内存分配来说,堆内存的分配远比栈内存来的复杂
在大量创建小对象的情况下(比如解析JSON文件),堆分配的累积开销会显著影响性能
其次,随着时间和科技的进步,现代 CPU 的速度已经远远超过了主内存(RAM)的访问速度——一次缓存命中只需要 1 到 5 个时钟周期,而一次缓存未命中可能需要 100 到 300 个时钟周期
CPU 设计者通过多级缓存(L1、L2、L3)来缓解这个差距,缓存的核心策略是空间局部性:相邻地址的数据更可能被连续访问
但纯引用语义彻底破坏了这种空间局部性
在你尝试遍历一个数组(里面全是对象)的情况下,
每个对象都在堆内存的各个角落,在读取每一个对象的时候,都需要先解引用指针,在跳转
每一次都可能触发缓存未命中
这是著名的"指针追逐"(Pointer Chasing)问题。在数据密集型的场景下,这种内存访问模式可能让程序的实际性能比理论值低一个数量级
同时由于对象为引用类型(下一节会讲),这种设计在多个指针指向一个对象的时候,任何一方对对象状态的修改,都会被其他持有者立即看到。
程序员需要时刻警惕"共享可变状态"的问题,要么使用不可变类(NSArray 而非 NSMutableArray),要么在传递可变对象时显式调用 copy 来创建副本。这种额外的认知负担在大型团队协作中容易引发难以追踪的 Bug
值语义重新成为一等公民
在如今的语言中(还是以swift语言举例子,真的不是因为我就会这两种语言)
Swift 提供了两套平行的对象模型,让开发者根据场景自由选择:
第一种是 struct 和 enum,它们采用值语义,默认分配在栈上(或者作为其他对象的内联成员)。它们没有 isa 指针,没有引用计数,赋值时进行拷贝(虽然 Swift 通过 Copy-on-Write 机制做了优化,避免了不必要的拷贝开销)
第二种是 class,它采用引用语义,分配在堆上,行为与 Objective-C 的对象一致
Swift 标准库的设计哲学非常激进——绝大多数核心类型都是 struct:String、Array、Dictionary、Set、Optional 全部都是值类型。只有那些天然需要共享身份的类型(如 NSObject 的子类、UI 组件)才使用 class
这个设计带来了几个显著的好处:
- 性能提升:栈分配几乎零成本,连续内存对 CPU 缓存极其友好。
- 线程安全:值类型天然不存在共享可变状态问题,可以安全地在多线程间传递。
- 可预测性:值的修改永远是局部的,不会意外影响其他持有者。
Objective-C 选择了纯引用语义的统一形态,是因为它需要解决的核心问题是"如何在 C 语言之上构建一个简洁的面向对象模型"。在那个年代,CPU 与内存的速度差距还不悬殊,堆分配的开销也可以接受,统一性带来的设计简洁性远比微小的性能损失重要
Swift 引入双形态系统,是因为现代应用对性能和正确性的要求更高了。值语义不仅能带来性能提升,还能从语言层面消除一类常见的并发 Bug。但它依然保留了 class,因为引用语义在某些场景(如 UI 组件的身份保持)依然是最自然的选择
对象在内存中以何种形态存在,决定了它的性能特征、生命周期管理方式、并发行为以及开发者的心智模型。 这是一个牵一发而动全身的根本性决策,也是为什么我们把它放在第 0 层(前置决策)来讨论的原因
我们讲完了引用类型的设计思路,再讲一下值类型的部分内容
值类型语义与引用类型语义有相当大的区别,
值类型赋值即拷贝,每个变量持有自己的独立副本,修改互不影响
引用类型语义赋值即共享,多个变量指向同一个实体,修改会影响所有持有者
OC这边,我们刚刚也讲过,所有的对象都是引用类型,
当然值在OC里也存在,但是这部分需求被让渡给了C语言,即值对象的实现为没有isa指针,不能接收消息的C结构体,例如CGPoint
现代编程语言,比如swift,它选择重新让值类型成为对象的一等公民
引用类型只在真正需要的时候使用
当然这样会有一个 潜在的问题,即大对象的拷贝开销,比如 100 万个元素的数组,每次赋值都需要拷贝整块内存
Swift 通过一个叫做 Copy-on-Write(写时拷贝) 的精巧机制解决了这个问题。它的核心思想是:值类型在赋值时不立即拷贝,而是共享底层存储;只有当某一方真正发起修改时,才执行拷贝操作
当然这些并不是我们今天要讨论的重点,但是我们应该知道
面向对象编程对"对象"的理解,正在从"一切皆引用类型"回归到"按语义需求选择形态"
类型
这个对象到底能做什么
如果说形态确定了对象在内存中以何种姿态存在,那么类型策略要回答的是一个更具哲学意味的问题:系统在什么时候、以什么方式来判断"这个对象能做什么"?
这个问题听起来很抽象,但是实际上他的答案直接决定了你的代码什么时候会崩溃,性能瓶颈在哪里,IDE能给你提供多少帮助,重构一个大型项目需要的时间
在我们写下[obj doSomething] 时,"obj 是否真的能响应 doSomething 这个调用"这个判断,应该在什么时候完成?
在静态类型里,编译器会检查你的每一个方法调用,这个对象的类型声明里是否有这个方法,参数类型是否正确,参数是否正确,返回值是否正确,任何一个环节出现问题,编译器都会拒绝生成文件
这种设计的核心理念是错误应该尽可能的早被发现,
在程序运行之前发现错误远比用户使用的时候才崩溃要好的多
但是代价就是开发者必须向编译器交代清楚每一个对象的类型
在动态类型下,编译器则只负责提建议,它只会做一些基本的语法检查,但是不会强制你交代清楚所有的类型关系,真正的判断推迟到了程序运行时
当代码执行到了某个方法调用的时候,运行时才会去检查这个对象到底能不能响应这个消息
这种哲学的核心信念是,程序的灵活性要比静态安全更重要
代价则是某些类型错误只能在运行时才暴露出来
理解了这两种类型之后,我们就能审视OC在这个维度做了什么
OC表面上披着静态类型的外衣,骨子里却把所有的类型决策全都推迟到了运行时
这种做法让它有了无与伦比的灵活性,但是也埋下了很多深层次的代价
当你在 OC 里写下 NSString *name = @"Alice" 时,编译器看到了类型声明 NSString *。它会做一些基础的检查工作——比如你后面调用 [name length] 时,编译器会去 NSString 的接口声明里查一下,确认确实有 length 这个方法,于是放行。
这看起来很像静态类型,对吧?但 OC 的表层静态有一个非常关键的特征——它是非强制的,本质上只是友善提示
具体来说,OC 的编译器在面对类型不匹配时,绝大多数情况下只会给你一个警告,而不是错误。你完全可以无视这些警告强行编译通过:
NSString *name = (NSString *)@[@1, @2, @3];  // 把数组强制转成字符串

[name length];  // 编译通过,运行时才会崩溃
更夸张的是,OC 还提供了一个完全绕过类型检查的"逃生口"——id 类型。任何对象都可以被声明为 id,编译器对它放任自流,不做任何方法存在性检查:
id mystery = @"Alice";

[mystery doSomethingThatDoesntExist];  // 编译器完全不报错
这种表层的"软静态"特征,让 OC 看起来像一门静态类型语言,但它的静态部分非常容易被绕过,更像是一层装饰而不是真正的防护。
OC 真正的类型决策完全发生在运行时。当你写下 [obj doSomething] 这行看似普通的代码时,编译器会把它悄悄翻译成一个 C 函数调用:
objc_msgSend(obj, @selector(doSomething));这个 objc_msgSend 是 OC 运行时的核心,他在每次调用的时候都会完整运行一遍查找流程
详细流程我们会在Runtime里详细讲解,我们只需要知道这个流程是完全运行时的,每次方法调用都需要走一遍
OC 选择这种双层结构是有深思熟虑的。表层的静态提示让普通的代码错误能够被早期发现(拼错方法名、传错参数类型),底层的动态决议则保留了运行时的所有灵活性。这是一种试图同时获得静态类型的便利和动态类型的灵活的折中方案。
但这种折中也意味着——当便利和灵活性产生冲突时,OC 永远选择灵活性。这就是为什么它的静态层只是警告而不是错误、为什么它提供了 id 这个万能逃生口、为什么 Method Swizzling 这种运行时改变方法实现的操作是合法的
动态类型如何支撑解耦、连线与扩展
为什么这么设计?
有这么几点:
- 如何让对象之间真正解耦合
- 如何实现可视化界面的运行时连线
- 如何让框架在不修改源码的情况下扩展
我们一个一个来讲解
在静态类型语言中,对象之间的调用关系在编译期就被钉死了。如果 A 类想调用 B 类的方法,A 必须在编译时就完整地知道 B 的类型定义,必须 #include B 的头文件。这种紧耦合在大型项目中会带来严重的连锁反应——任何一个被广泛引用的类的修改,都可能引发整个项目的重新编译
更深层的问题是——这种紧耦合让"可重用组件"变得几乎不可能。一个理想的可重用组件应该能够在不知道使用者具体类型的情况下工作,但静态类型系统强制要求在编译期就把所有协作类型确定下来
OC 的动态类型从根本上解决了这个问题。一个对象可以持有 id 类型的引用,运行时再决定它到底是什么类。这是 Cocoa 框架中广泛使用的 Delegate(委托)模式的基础
NeXTSTEP(macOS 的前身)在 1980 年代末革命性地推出了 Interface Builder——一个让开发者用拖拽的方式设计界面、用连线的方式连接交互逻辑的可视化工具。
这种交互模式在当时是颠覆性的(当然现在不是了....而且由于很多年没更新,现在难用的要命...)
但 Interface Builder 的实现机制对类型系统提出了一个看似无解的挑战——它需要在不重新编译代码的情况下,把界面元素的事件连接到任意对象的任意方法上
如果使用静态类型系统,这是几乎不可能实现的。你怎么能在编译期就预先确定一个还没设计好的界面元素会调用哪个对象的哪个方法呢?
但在 OC 的动态类型系统下,这个问题变得非常简单。Interface Builder 只需要把"目标对象"和"方法名"作为字符串保存在配置文件里。运行时通过 NSSelectorFromString() 把字符串转成 selector,通过 objc_msgSend 派发消息,整个过程完全跳过了编译期的类型检查
OC 的 Category(分类)特性是动态类型带来的另一个独特能力。它允许你在不修改原始类源码的情况下,给任何类(包括系统类)添加新方法
很多第三方库的底层实现也是使用这种方法来给一些官方的类提供方法的
这个特性的底层实现完全依赖于动态类型——Category 在程序加载时把新方法注入到目标类的方法表中,运行时的 objc_msgSend 在查找时根本不区分这个方法是原始定义的还是 Category 注入的
这种"事后扩展"的能力让 OC 生态形成了独特的编程范式。开发者可以为系统类添加便利方法,可以在不接触原始代码的情况下修复别人的库的 bug,可以以非侵入的方式增强第三方代码。这些在静态类型语言中几乎无法实现
除了分类使用了动态注入,方法交换也使用了类似的原理
由于方法查找完全发生在运行时,你可以在程序启动时动态地交换两个方法的实现
同之前所说一样,这种动态的形式实际上是有很大的弊端的
静态类型的理论在于尽可能在编译期就解决所有的问题,即动态类型的代价就是,很多问题只能等到运行时才能被发现
更加糟糕的是,有些时候这些问题的出现是由于动态返回数据,比如说服务端返回的JSON结果
如果你的测试不够完全,则问题很可能会拖到发布应用,一个倒霉的客户走到了一个异常不常见的分支里,然后软件爆炸
同时由于每一次方法调用都需要经过一次查找流程,虽然苹果自己做了大量的优化(每个类各自的方法缓存,即 IMP 缓存等),但这个开销与静态直接绑定的方法调用相比依然存在显著差距
而且由于动态分派的存在,编译器无法做内联优化、常量传播、死代码消除等关键优化。一个简单的循环体内的方法调用,在 C++ 里可能被完全内联展开,而在 OC 里每次都要走完整的消息派发流程
这也是为什么 Apple 许多性能敏感的框架(如 Core Graphics、Core Audio、Accelerate)大量使用 C/C++ 而非 OC——它们承受不起动态派发的性能开销
这种问题在后期的维护和重构也能体现出来,由于方法是动态的,代码的真实行为变得难以追溯,当你看到一个对象的时候,你不知道它的方法是不是被方法交换改写过,是不是被分类注入了新方法,有没有在运行时添加了功能
代码的静态外观与运行时实际行为之间存在巨大的鸿沟
在调试的时候,开发者一定要建立起一个更为复杂的心智模型,你不仅需要知道每个对象声明的类型是什么,还需要知道它的运行时实际上是什么,在涉及KVO,方法交换的时候,这种负担会迅速增长
Swift 如何把类型决策拉回编译期
现在的Swift在类型策略的核心理念是默认严格,按需放松,它的类型系统比OC严格了一个数量级
首先,所有的类型都必须在编译期确定,swift没有id这样的万能类型,如果你需要类型擦除,必须显式使用 Any 或 AnyObject,这种代码会被代码审查者特别关注
其次,协议取代了动态接口,Swift用协议来描述对象可以做什么,但是对协议的检查发生在编译期。如果你试图把一个不遵守 Clickable 协议的对象传给 processClick 函数,编译器会直接拒绝你的代码,根本不会让程序进入运行阶段
第三个根本性变化是方法派发的多种模式。Swift 提供了多种派发方式让开发者根据需要选择:
- 静态派发:对于
struct、enum和final class,方法调用在编译期就被解析为直接的函数跳转,性能与 C 函数调用相当。 - 虚表派发:对于普通的
class,使用类似 C++ 虚函数的虚表机制,单次间接跳转。 - 见证表派发:对于协议方法,使用编译期生成的协议见证表(Protocol Witness Table)。
- 消息派发:只有标记为
@objc dynamic的方法才会走 OC 风格的运行时派发。
这种"多模式派发"的设计让 Swift 既保留了与 OC 互操作的能力(通过@objc标记),又能在大部分情况下享受静态类型的性能优势和安全保障
1980 年代软件开发面临的核心挑战是"如何构建灵活的、解耦的面向对象系统"。
代码库规模相对较小,CPU 性能足够富裕,崩溃可以接受,重构频率不高
开发者主要关注的是"能不能用面向对象的方式优雅地建模业务"。在这样的背景下,运行时的灵活性带来的收益远远超过了它的代价
但在现在,代码库规模急剧变大,移动设备的性能虽然上升但是用户对性能的要求变得更高了,并且大型团队协作编程变得更加常见,运行时的崩溃(即在客户手中的崩溃)变得不可以接受。
在这样的背景下,Swift把类型决策拉回到了编译期
悲哀的是,OOP的创始人在邮件里曾经写到:
”OOP to me means only messaging, local retention and protection and hiding of state-process, and extreme late-binding of all things. It can be done in Smalltalk and in LISP. There are possibly other systems in which this is possible, but I'm not aware of them.“
“面向对象对我来说只意味着消息传递、状态的本地保存与保护以及状态过程的隐藏,以及一切事物的极端延迟绑定。这可以在Smalltalk和LISP中实现。可能还有其他系统能做到这一点,但我不知道。”
对于OOP即面向对象编程来说,我们都知道有三个特点
封装
继承
多态
但是实际上,从他自己上面那段话就能看出,Alan Kay 真正强调的是消息传递与极端晚期绑定,其次才是状态的封装与隐藏
至于继承与多态,更多是后人总结出来的,并不在他最初设想的核心里
继承与多态在实际业务中,会产生一棵复杂,庞大的继承树
除了继承树,很多人写代码实际上是在面向过程编写
在一个ViewController中,重写方法。再推测用户可能的行为,再重写
这本质就是面向过程,而不是Alan Kay说的类似生物细胞的对象
Alan Kay所想的极端延迟绑定,则在AI时代极端的不友好,开发者大批量使用AI来编写代码导致了对自己项目运行时行为细节的掌握大不如前,这恰恰违背了“开发者对运行时行为有充分的心智模型”这一前提条件
好在Alan Kay自己觉得最重要的核心——消息传递这一机制则在AI时代以另一种方式活着(方法调用)
身份
两个引用是不是同一个对象
前三章我们分别讨论了对象的本质(它是什么)、对象的形态(它在内存中以什么姿态存在)、对象的类型(系统在什么时候判断它能做什么)
现在我们来到最后一个问题,也是最容易被忽略却又无处不在的问题:当我手里有两个引用时,我怎么判断它们指向的是不是"同一个"对象?一个对象的"身份",到底由什么决定?
这个问题实际上贯穿了我们写的每一行代码。
当你把一个对象放进 NSSet、当你用一个对象做 NSDictionary 的 key、当你判断 delegate == self、当你在 KVO 里追踪"是哪个对象发生了变化"——你每一次都在依赖系统对"身份"的定义
我们先回到形态那一章的结论:在 OC 里,你手里握着的永远是一个指针,它记录的是对象在堆内存中的物理坐标。
这个结论直接给出了 OC 对身份最朴素、也最暴力的回答:对象的身份,就是它的内存地址。
当你写下:
if (objA == objB) { ... }你以为你在比较"两个对象是否相等",但实际上编译器把这两个 id 当成两个普通的指针(8 字节整数)来比较。== 比较的从来不是对象的内容,而是这两根"风筝线"是不是拴在同一个堆地址上。只有当 objA 和 objB 是同一次 alloc 出来的那块内存时,== 才为真。
这就引出了 OC 世界里一组极易混淆,但性质完全不同的概念:同一性与相等性
- 同一性回答的是"它们是不是同一个对象",用
==判断,本质是地址比较 - 相等性回答的是"它们是不是逻辑上等价",用
isEqual:判断,本质是内容比较
有意思的是,NSObject 的 isEqual: 默认实现是这样的:
- (BOOL)isEqual:(id)object {
    return self == object;
}
也就是说,如果你不重写 isEqual:,那么"相等"就退化成了"同一"。这是 OC 给所有对象的默认身份观——每个对象天生只和自己相等。
只有那些有"内容"语义的类(如 NSString、NSNumber、NSArray)才会重写 isEqual:,让两块不同内存里装着相同内容的对象被判定为相等:
NSString *a = [NSString stringWithFormat:@"Hello, %@", @"Objective-C"];
NSString *b = [NSString stringWithFormat:@"Hello, Objecti%@", @"ve-C"];

a == b;          // NO,两块不同的堆内存(__NSCFString)
[a isEqual:b];   // YES,内容都是 "Hello, Objective-C"
一旦你决定重写 isEqual:,你就和系统签下了一份契约——你必须同时重写 hash。
这份契约的规则只有一条:如果 [a isEqual:b] 为真,那么 a.hash 必须等于 b.hash
为什么?因为 NSDictionary 和 NSSet 这类基于哈希表的容器,是先用 hash 把对象快速定位到某个桶(bucket),再在桶内用 isEqual: 做精确比对。如果两个相等的对象算出了不同的 hash,它们会被扔进不同的桶里,容器会认为它们是两个毫不相干的东西,你的去重、查找逻辑会彻底失效。
反过来,hash 相等并不要求 isEqual: 也相等(这是允许的哈希冲突),但 isEqual: 相等就必须 hash 相等。这是一条单向的约束,无数 Bug 都源于开发者重写了 isEqual: 却忘了 hash,而编译器对此一声不吭。
身份与可变性在这里会撞出一个经典的陷阱。假设你把一个可变对象放进了集合,然后又修改了它:
NSMutableSet *set = [NSMutableSet set];
NSMutableArray *obj = [@[@1] mutableCopy];

[set addObject:obj];        // 此刻 obj 的 hash 决定了它的存放位置
[obj addObject:@2];         // 修改了 obj,它的 hash 随之改变

[set containsObject:obj];   // 可能返回 NO —— obj 明明还躺在 set 里
你修改了 obj 的内容,它的 hash 也变了,于是它应该在的那个桶和它实际所在的桶对不上了,集合的哈希结构被你从内部破坏掉了。
这就是为什么 NSSet 的成员、NSDictionary 的 key 都应当是不可变的。NSDictionary 更进一步,在插入时直接对 key 执行 copy,强行冻结 key 在那一刻的身份快照(这也是 key 必须遵守 NSCopying 协议的原因);而 NSSet 只是 retain 成员、并不 copy,所以一旦你把可变对象放进去再修改,就会出上面这种事。
更微妙的是,OC 在性能优化的过程中,亲手模糊了"身份就是地址"这条铁律。而且它用的不止一种手段,我们分两层来看。
第一层,编译期常量对象。 对于 @42、@"hello" 这样的字面量,编译器会在编译期就把它们生成为常量对象,直接塞进二进制的常量区,并且做去重——同一个字面量通常只存一份。于是:
NSNumber *a = @42;
NSNumber *b = @42;
a == b;   // YES

NSString *s1 = @"hello";
NSString *s2 = @"hello";
s1 == s2; // YES
此时 [a class] 你会看到 NSConstantIntegerNumber,[s1 class] 是 __NSCFConstantString,它们都有真实的内存地址,只是这个地址被多个变量共享。换句话说,这里的 == 之所以为真,恰恰是因为它们真的就是同一个对象(同址)——同一性的定义并没有被破坏,只是"看起来该是两个对象"的直觉被编译期去重打破了。
第二层,Tagged Pointer(标记指针)。 这一层才是真正把"地址"这个概念偷换掉了。为了避免给小对象做昂贵的堆分配,苹果对足够小的值(短的 NSNumber、短的 NSString)干脆不分配堆对象,而是把值直接编码进指针本身——那个"地址"里装的根本不是坐标,而是数据。它通常出现在运行时临时构造的小对象上:
NSString *a = [NSString stringWithFormat:@"He%@", @"llo"];  // "Hello",很短
NSString *b = [NSString stringWithFormat:@"Hel%@", @"lo"];

a == b;   // YES —— 但这次不是因为"同一个对象"
[a class] 会告诉你它是 NSTaggedPointerString。因为内容相同的标签指针,其指针值是由内容算出来的、逐位相同,所以 == 为真——可这两个"指针"压根不指向任何堆对象,"地址即身份"在这里彻底失去了意义。注意对比上面那个长字符串的例子:同样是 stringWithFormat:,长到走堆分配时 == 为 NO,短到能塞进指针时 == 又成了 YES,结果完全取决于内容长度。
一个历史细节:在较老的工具链上,
@42也会落成 tagged pointer(运行时的numberWithInt:),[obj class]显示__NSCFNumber。结果同样是==为真,所以你在不同环境跑出来的类名可能不一样,但结论一致。
这两层优化叠在一起,意味着——在 OC 里,你永远不应该用 == 去判断两个值对象是否"相等"。== 偶尔会"碰巧"给你正确答案,但那要么是编译期去重、要么是标签指针的副作用,而不是语义的保证。判断内容,请永远使用 isEqual:。
讲到这里我们要澄清一个容易混淆的点:身份和类型是两件完全不同的事。
回顾本体论那一章,isa 指针告诉外界"我是什么类"。但 isa 决定的是类型,不是身份。身份是对象的地址,类型是 isa 指向的那个类对象。
一个有力的证据是:你可以在运行时用 object_setClass() 把一个对象的 isa 改掉,让它"变成"另一个类(KVO 的底层正是这么干的),但这个对象的地址没变,它的身份就没变。对象还是那个对象,只是换了一张说明自己是谁的"身份证"。
换句话说,在 OC 里,身份是比类型更底层、更稳固的存在。一个对象可以改变它的所有属性,甚至改变它的类,但只要它的内存地址不变,它就还是"它"。这其实暗合了一个古老的哲学命题——忒修斯之船:当一艘船的所有木板都被替换之后,它还是原来那艘船吗?
OC 的回答干脆利落:只要地址没变,就是。身份不在于状态,而在于那个独一无二的位置。
地址即身份为什么成立
那么 OC 为什么敢用"地址即身份"这么朴素的方案?
因为它在形态那一章就已经做好了铺垫。OC 的对象一律堆分配、引用语义,而且——关键在于——OC 的对象在其生命周期内地址永不改变。OC 没有移动式垃圾回收(compacting GC),对象一旦分配,就钉死在那个地址上,直到被释放。地址的稳定性,是"地址即身份"得以成立的物理前提。
这个方案的好处是显而易见的:
- 极致的廉价:判断同一性只需要一次指针比较,一条 CPU 指令的事,不需要任何额外的 ID 字段
- 天然的稳定:只要对象活着,它的身份就绝对不会变,不需要任何维护成本
- 支撑了整个 Cocoa 的协作模型:Delegate 要知道"是不是我设的那个委托"、NotificationCenter 要知道"该把通知发给哪个观察者"、KVO 要追踪"是哪个对象的属性变了"、target-action 要记住"按钮该把消息发给谁"——这一切都建立在"每个对象有一个廉价且稳定的身份"之上
但这套身份观也付出了代价:
同一性与相等性的长期混淆
==和isEqual:的区别是 OC 新手最常踩的坑之一。语言把"比较"这个动作用同一个符号==同时赋予了"比地址"和"比内容"两种直觉,而实际行为取决于操作数是指针还是标量、取决于对象有没有重写isEqual:。这种语义的暧昧让大量字符串比较的 Bug 静静地潜伏在代码里isEqual:/hash契约的沉重负担
一旦你想要值语义的相等,你就必须手动、正确地实现一对相互呼应的方法。这份契约没有编译器帮你检查,写错了也不会报错,只会在某个哈希容器里悄悄丢数据,等到线上才暴露可变性对身份的侵蚀
对象的内容可变,但用于哈希的身份快照需要稳定,这两者天生矛盾。开发者必须时刻警惕"别拿可变对象当 key"、"别在对象进集合之后修改它参与哈希的字段"缺乏稳定的逻辑身份
这是最深层的一个问题。OC 的身份是"内存身份",它只在对象这一次的生命周期内有效。但在真实业务里,我们关心的往往是"逻辑身份"——同一个用户、同一篇文章、同一个订单。当你从网络重新拉取一次数据,你得到的是一个全新的对象,新的地址,新的内存身份,但它在业务上和上一个对象是"同一个东西"。OC 在语言层面对这种"跨越对象生命周期的逻辑身份"毫无支持,你只能自己拿userID、objectID这样的字段去手动比对
从内存身份走向逻辑身份
现在我们来看 Swift 是怎么收拾这个局面的。
Swift 做的第一件事,是把 OC 用一个 == 和一个 isEqual: 混在一起的概念,拆成了三个边界清晰、各司其职的概念:
- 引用同一性,用
===和!==判断。它只能用于 class 实例,含义和 OC 的==比地址完全一致——它们是不是堆上的同一个对象 - 值相等性,用
==判断,由Equatable协议定义。Swift 把==从"有时比地址、有时比内容"的暧昧状态里解放出来,让它专一地表示"逻辑上是否等价"。更妙的是,对于struct和enum,编译器可以自动合成==的实现,你不用再手写那一长串字段比对 - 稳定的逻辑身份,用
Identifiable协议的id属性表达。这正是 OC 缺失的那块拼图——它允许一个类型显式声明"我的逻辑身份是哪个字段",哪怕对象被销毁重建,只要id相同,系统就认为是同一个实体。SwiftUI 的列表 diff 算法严重依赖它来判断"哪些行是新增、哪些是移动、哪些只是内容变了"
Hashable 协议则接管了 hash 的职责,同样支持编译器自动合成,并且 Swift 在语言层面规定了 Hashable 必须建立在 Equatable 之上——契约不再靠开发者自觉,而是被类型系统强制约束。
而 Swift 最根本的一个转变,藏在值类型里。
回顾形态那一章,Swift 的 struct 和 enum 是值语义的。对于一个值类型来说,"身份"这个问题根本不成立。两个内容相同的 struct 就是相等的,不存在"它们是不是同一个"的追问——因为值没有位置,没有地址,没有"这一个"和"那一个"的区别。Point(x: 1, y: 2) 永远等于另一个 Point(x: 1, y: 2),就像数学里的 1 永远等于 1。
这是一个深刻的简化。OC 因为一切皆引用,所以一切都背负着"身份"这个包袱,连一个本该是纯数据的坐标都要被迫拥有一个地址、一份同一性。而 Swift 让纯数据回归值语义,把"身份"这个沉重的概念,只留给那些真正需要它的实体(class)。
结语
至此,我们的四个前置问题就全部回答完了。让我们退后一步,把它们连起来看:
- 本体论告诉我们,OC 的对象本质是一个带
isa的 C 结构体 - 形态告诉我们,这个结构体被强制活在堆上,我们只能通过指针去触摸它
- 类型告诉我们,"它能做什么"这个判断被推迟到了运行时
- 身份告诉我们,"它是哪一个"这个判断,由它在堆上那个永不改变的地址决定
你会发现这四个答案环环相扣,全都源自同一个最初的决定——在 C 的结构体上注入 Smalltalk 的灵魂。正是因为对象是堆上的结构体(本体论),它才只能用指针引用(形态);正是因为用指针引用,地址才能天然地成为身份(身份);也正是因为这套结构要在运行时才被 isa 点亮,类型才得以延迟到运行时去决议(类型)。一个设计决策,长出了整棵树。
而 Swift 的演进,本质上是在同样的四个维度上,逐一给出"在不牺牲必要能力的前提下,让系统尽可能早、尽可能确定地做决策"的新答案:用值类型对抗堆分配,用编译期协议对抗运行时查找,用 Identifiable 把模糊的内存身份升华为清晰的逻辑身份。
理解了这四个前置策略,你再回头去看 OC 的 alloc、isa、objc_msgSend、isEqual:,它们就不再是孤立的知识点,而是同一套设计哲学在不同侧面的投影。在接下来的章节里,我们将真正潜入这套对象机制的内部,去看看这个由 isa 点亮的对象世界,到底是如何运转的。