并发处理一般是指同时执行多个逻辑控制流(在软件中实现)
从程序员的角度看,在应用层使用并发处理可以开发出以并行方式执行多个操作的应用程序
包括异步事件,访问I/O 设备,提供网络服务以及进行并行运算等
并发编程的基本原则
并发处理的优势
以应用程序级并发处理方式开发程序,可以使程序同步执行多个操作
为什么需要执行多个操作?
我们有一个非常棒的 App,点击之后,程序进入主线程,接着弹出一个线程上的运行循环以及框架代码,然后线程会在那里等待事件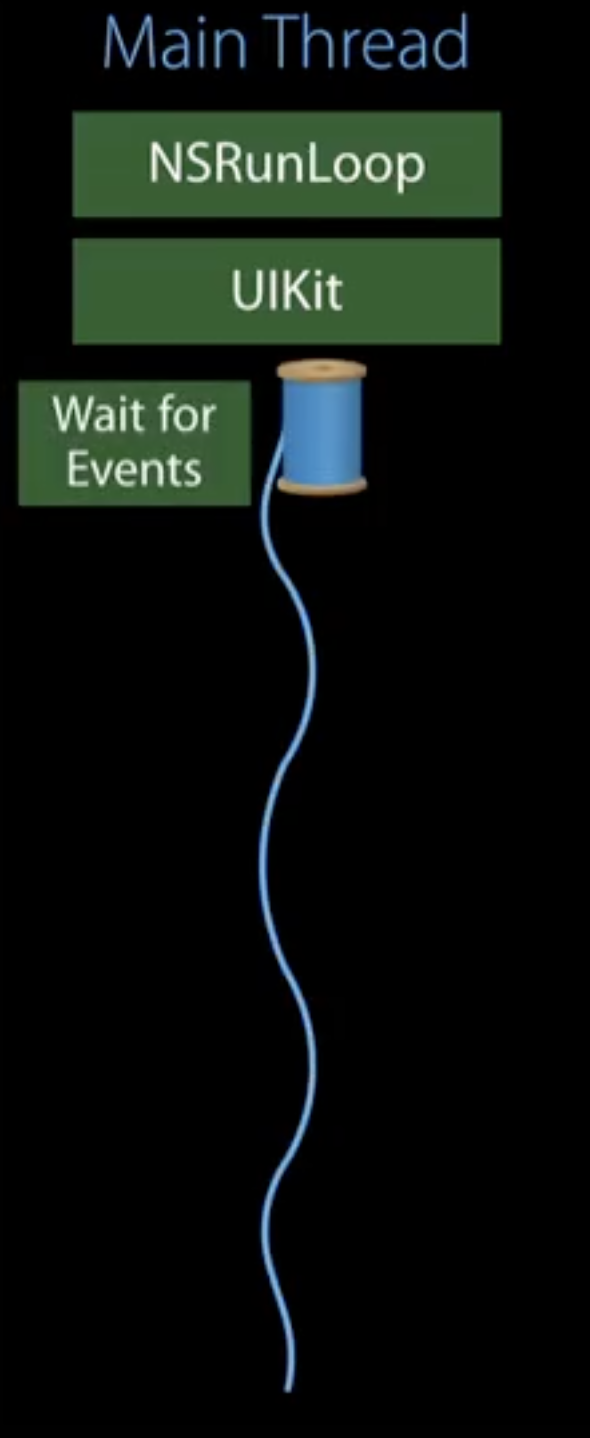
之后,你的程序可能会做一些操作,比如去数据库里取一些数据
这些代码都没什么问题,只是取数据可能会需要一些时间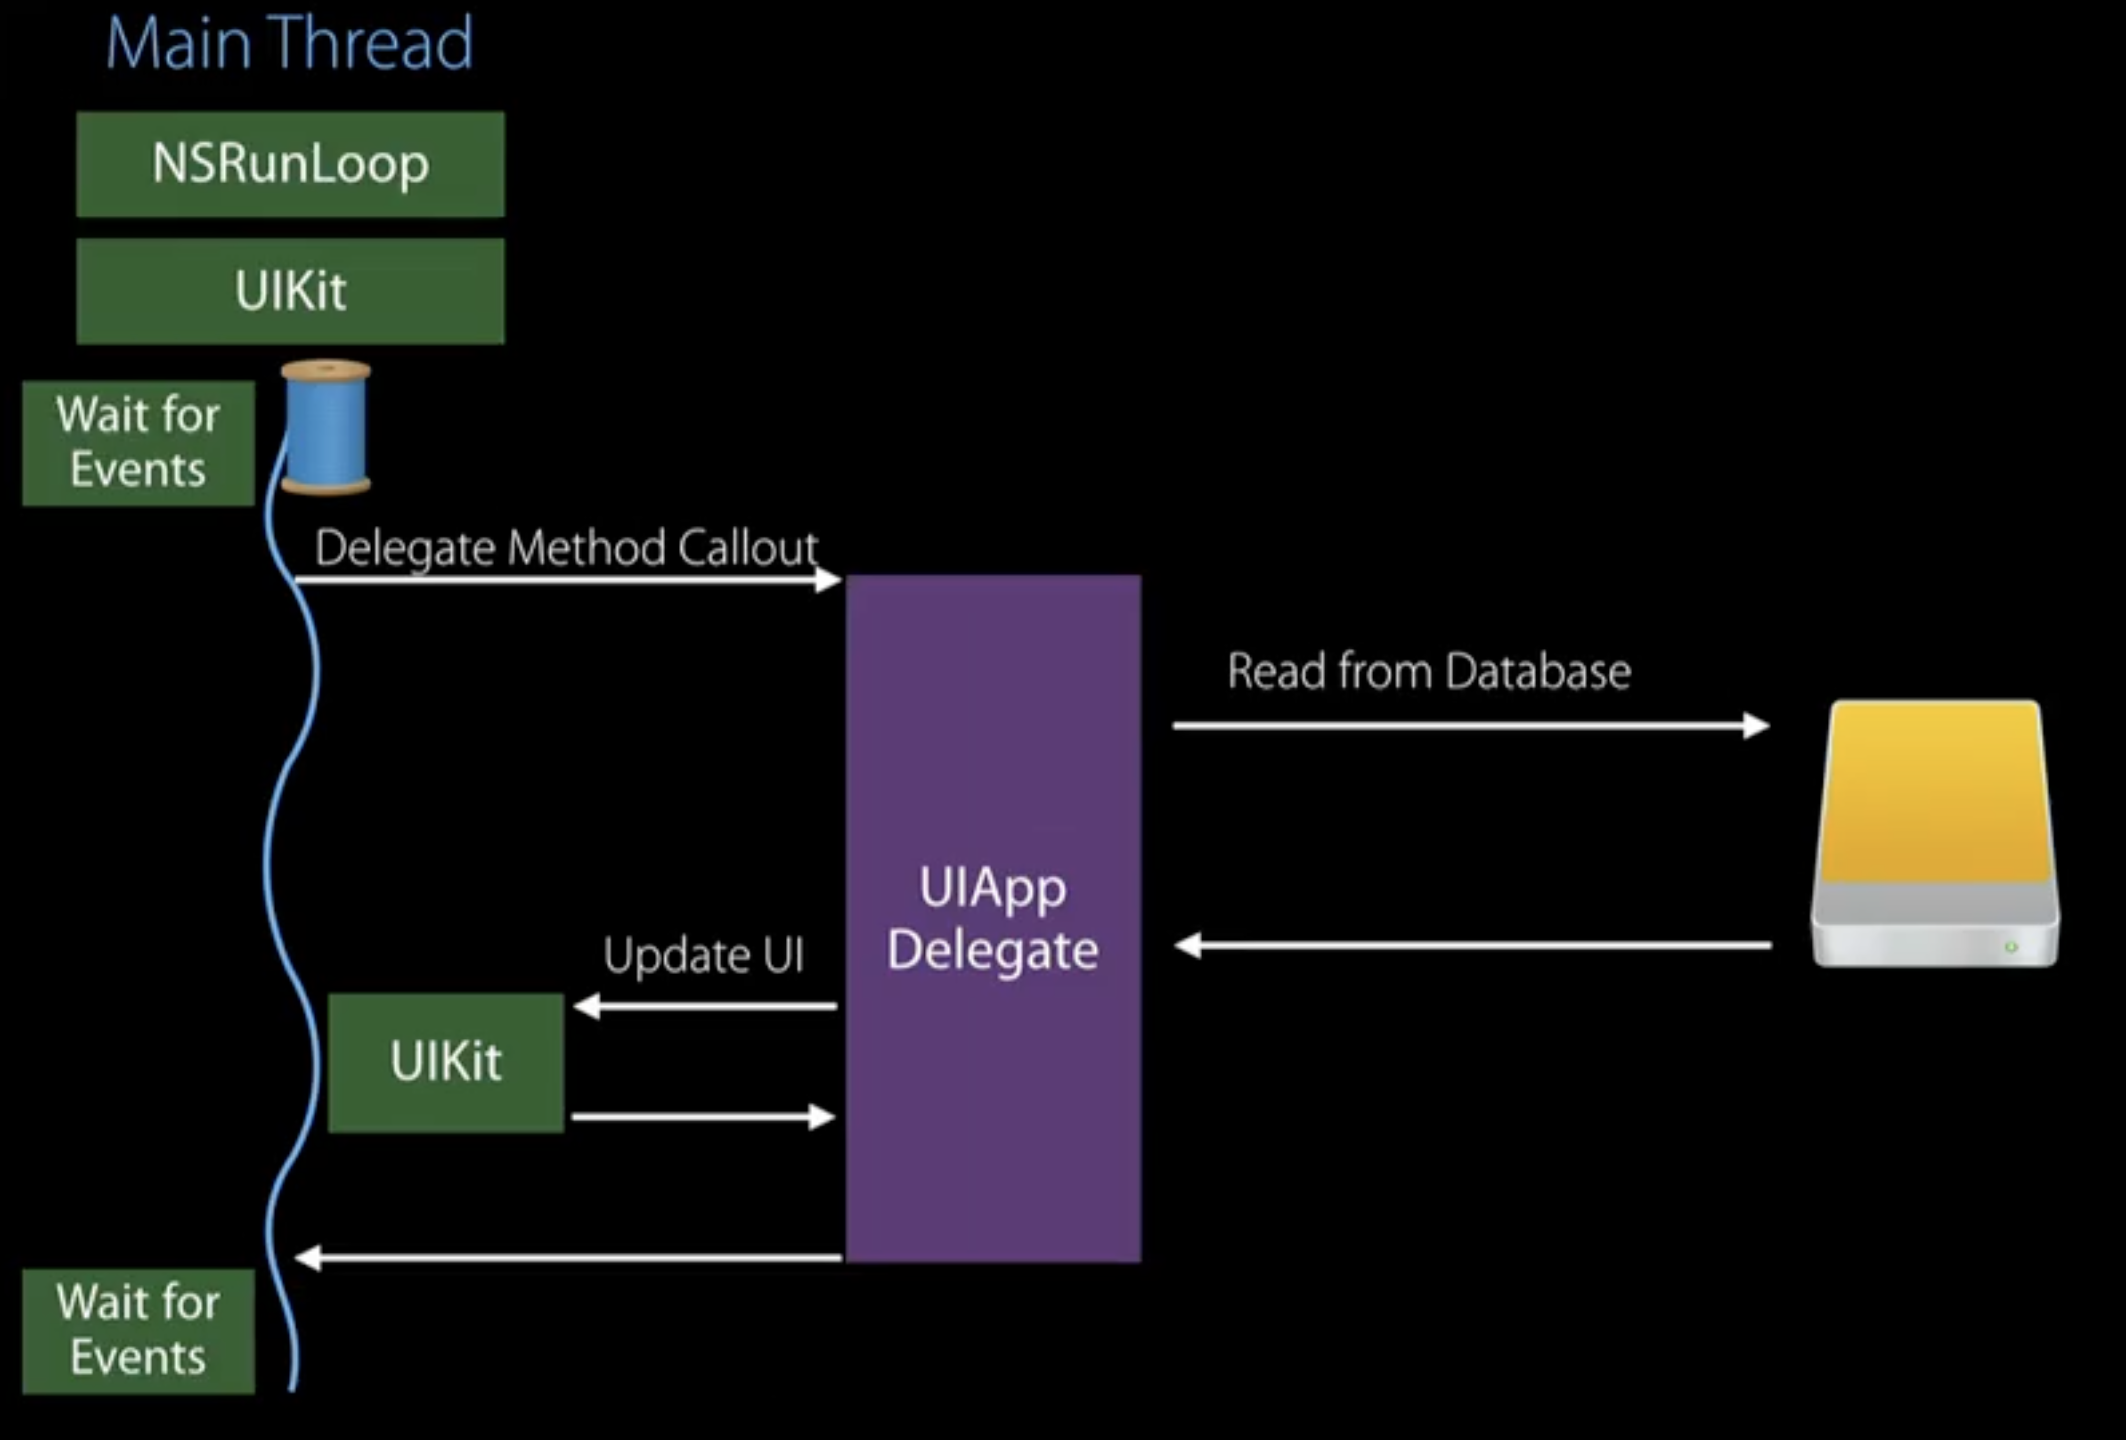
在这个时间里,App可能会被暂停,甚至被终止运行
这种用户体验很遭,而且得不到响应
出现这种情况,就可以使用并发处理的方式来处理程序,可以使程序同时执行多个操作,帮助提高运行效率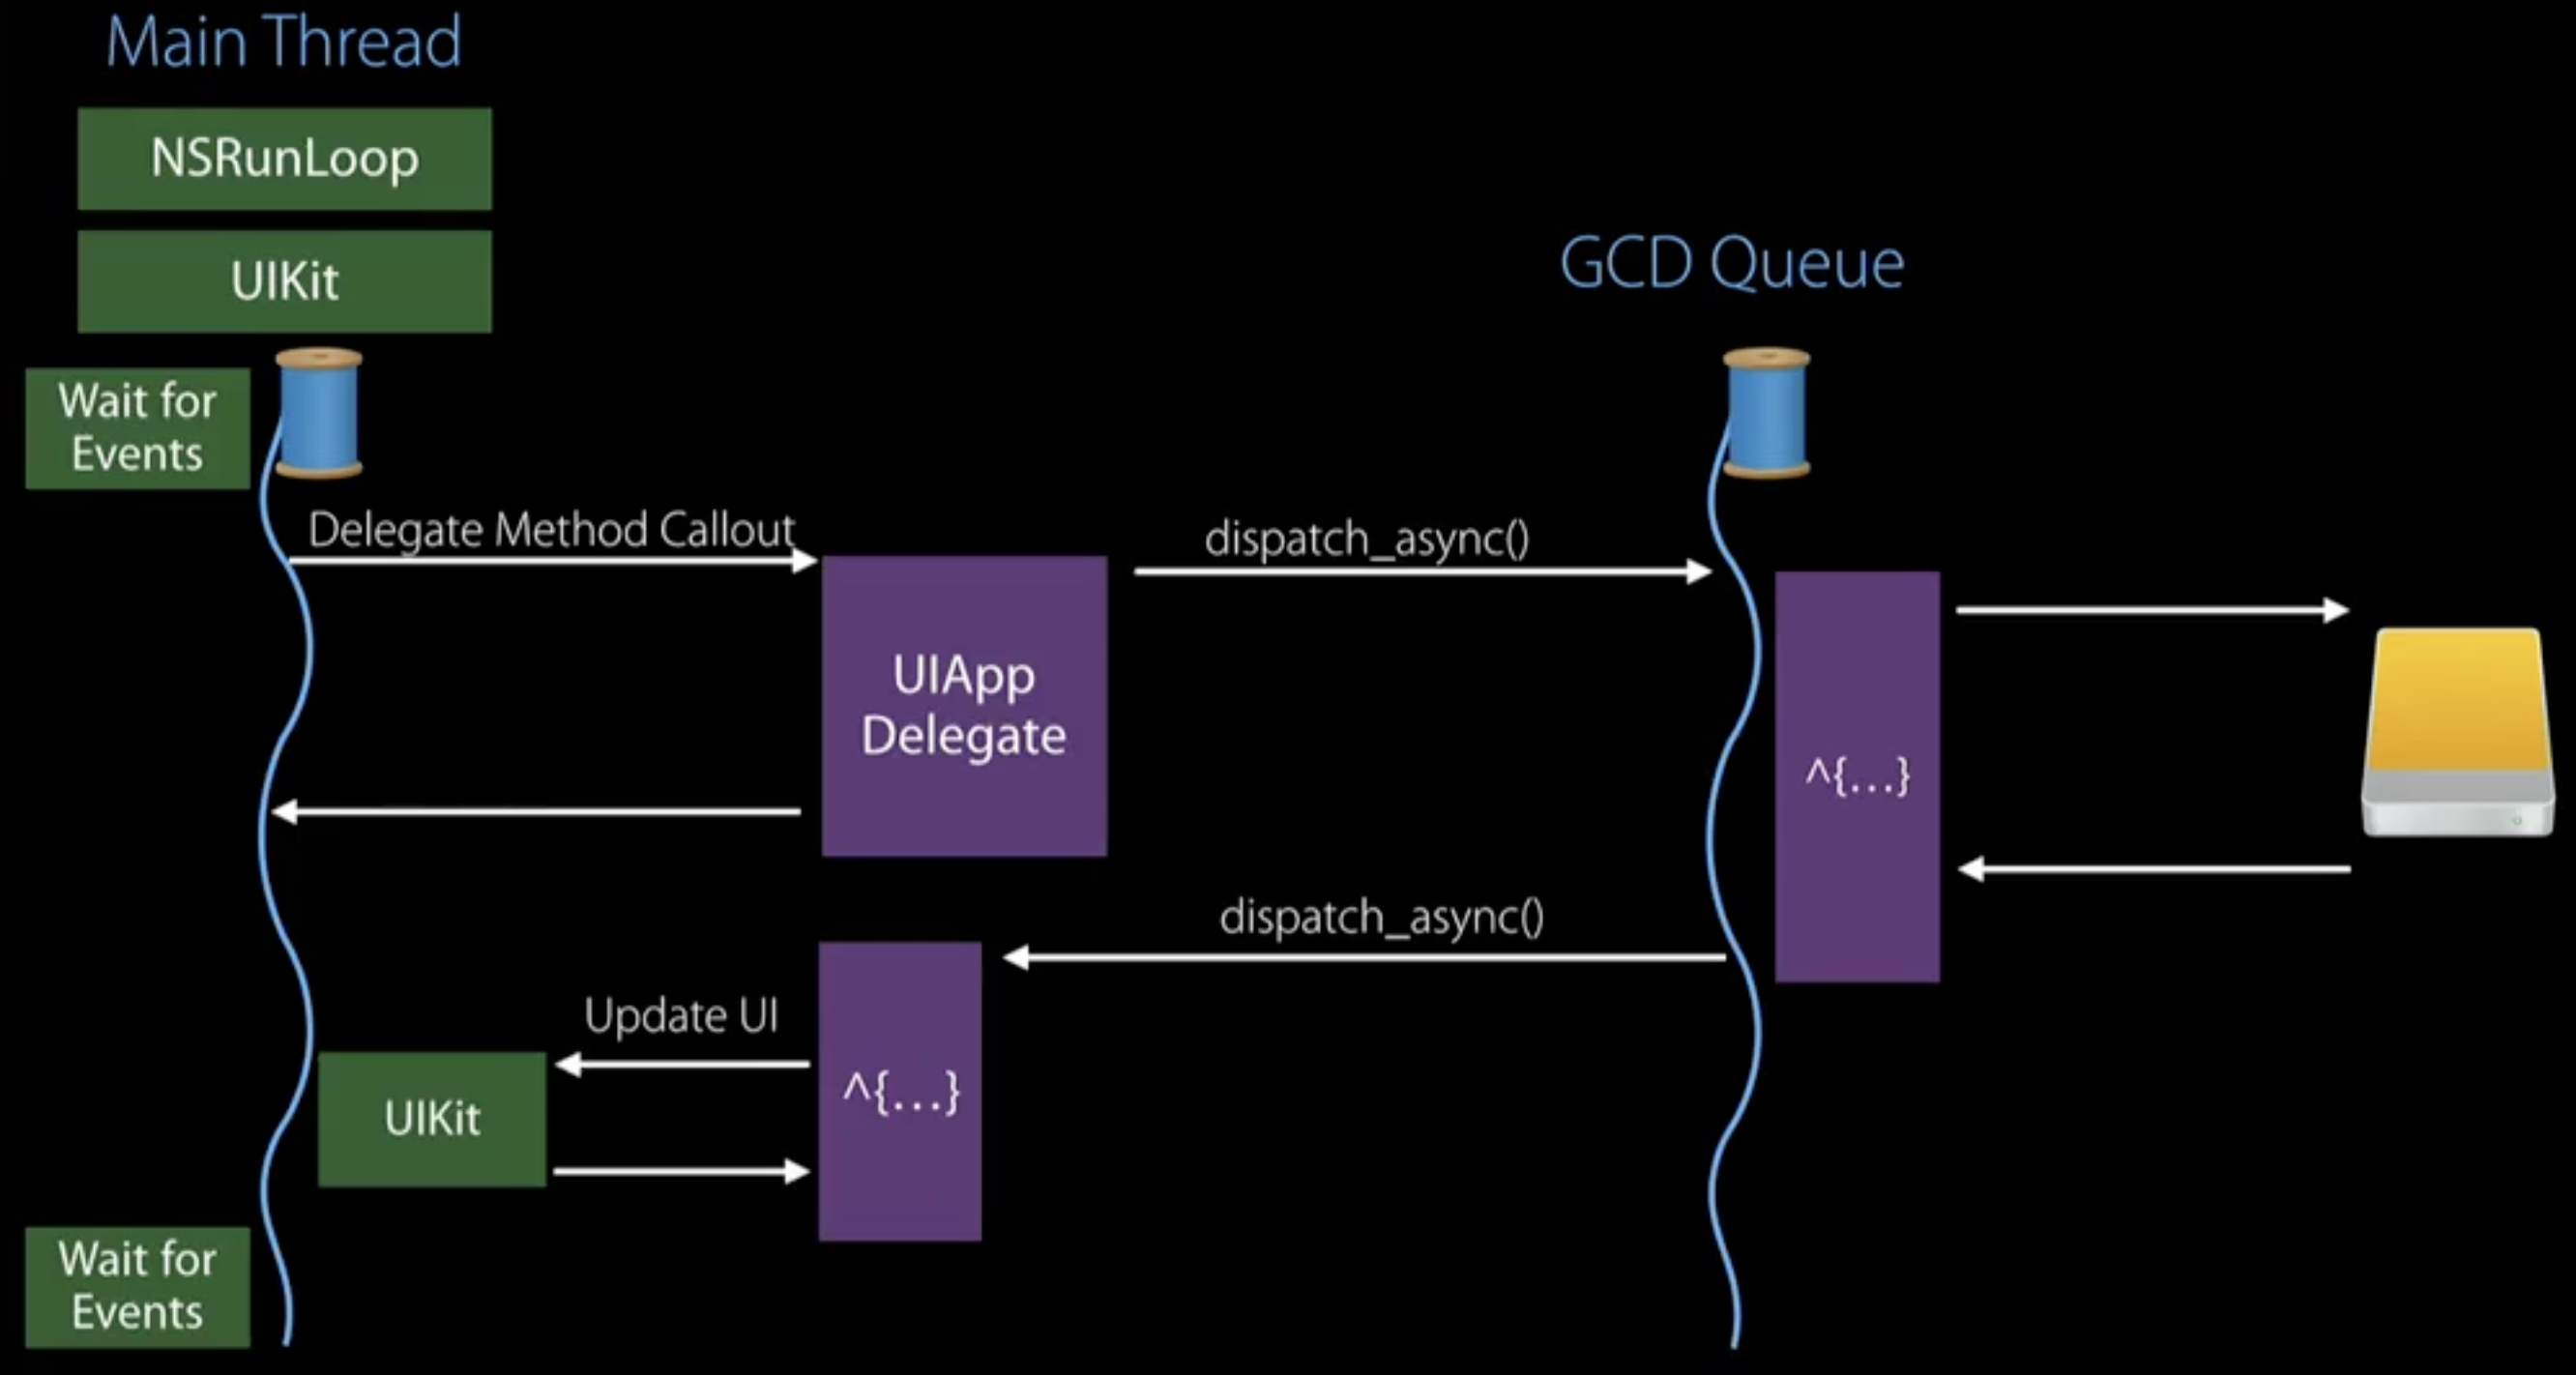
在启动后,我们创建一个新的线程,并在新线程里读取数据库。得到数据后,再回调,更新UI
这样做的好处是,在读取数据的时候,你的主线程仍然可以继续等待事件,它始终保持响应状态,用户始终有一个良好的体验
这是最简单的从用户的脚底出发
使用并发处理的好处很多,包括但是不限于以下几条:
- 增加应用程序的吞吐量:因为并发处理会使程序同时处理多个任务,而应用程序的吞吐量就是指在一段时间内应用程序能够完成的任务数,所以并发处理会比顺序处理完成更多任务
- 提高系统的利用率:以并发方式执行多个任务时,如果某个任务(如输入操作)正在等待,那么其他的任务也可以继续运行,因而能够减少应用程序的整体闲置事件,提高应用程序的响应性
- 更好的与问题领域契合:对某些问题进行解决的时候,可以将它们同时创建为同时处理的任务的集合,以并发方式处理
实现并发处理
如何利用并发处理?
在计算机系统中,实现并发处理的方式有很多,从使用指定的编程语言到计算机系统不一而足,常见的方式有以下几种:
- 分布式计算
- 并行编程
- 多进程
- 多线程
我们所讲的并发编程机制都以多线程方式为基础
并行处理带来的挑战
并行处理诚然有很多优点,但是正确的实现并不容易
其主要的难点在于进行同步操作和在并发执行的控制线程(即逻辑控制流)之间共享信息
此外,因为要同时执行控制流的多个线程,所以整个程序的执行顺序是不确定的。这会导致并发程序中的bug难以检测(复现难度大且复现随机)和修复困难
并且,多线程和它们之间潜在的交互会增加程序的复杂度,使得程序更加难以分析
解决上述问题的最常用的两种方式是共享内存和消息传递
共享内存编程模式会实现共享状态,也就是说,多个线程都可以访问某些程序数据,当程序中的多个线程共同使用某个地址空间的时候,共享内存就成了信息共享方式的自然之选
这种机制既快速又高效
服务质量等级(Quality of Service Classes)
应用和操作竞争使用有限的资源——CPU、内存、网络接口等等。为了保持响应性和效率,系统需要优先处理任务,并在何时执行它们时做出智能决策
直接影响用户的工作,例如UI更新,是非常重要的,并且优先于可能在后台进行的其他工作。这些优先级更高的工作通常会使用更多的能量,因为它们可能需要对系统资源进行大量和即时的访问
服务质量(QoS)类别允许对由NSOperation、NSOperationQueue、NSThread对象、调度队列和pthread(POSIX线程)执行的工作进行分类。
通过为工作分配QoS,指明了其重要性,系统将相应地对其进行优先级排序和调度。
例如,系统会比可以推迟到更优的时间执行的后台工作更早执行用户发起的工作。在某些情况下,系统资源可能会从优先级较低的工作重新分配给优先级较高的工作
系统使用QoS信息来调整调度、CPU和I/O吞吐量以及定时器延迟等优先级。因此,执行的工作在性能和能效之间保持平衡。
当为任务分配QoS时,请考虑它如何影响用户以及如何影响其他工作。
主要有四个QoS类别,每个类别对应一个工作重要性级别
主要QoS类别(按优先级顺序显示)
| QoS 类别 | 工作类型与 QoS 重点 | 执行耗时 |
|---|---|---|
| User-interactive 用户交互 |
与用户直接交互的工作:主线程操作、刷新 UI、执行动画等。如果不够快,UI 会卡死。 重点关注:响应性、性能。 |
几乎瞬间完成 |
| User-initiated 用户发起 |
用户主动触发且需要即时结果:打开文档、点击 UI 后的动作等。需要结果才能继续交互。 重点关注:响应性、性能。 |
几秒内完成 |
| Utility 实用程序 |
需要一定时间但不要求即时结果:下载、导入数据等。通常有进度条可见。 重点关注:响应性、性能、能效三者平衡。 |
几秒到几分钟 |
| Background 后台 |
后台运行、用户不可见:索引、同步、备份等。 重点关注:能效。 |
几分钟到几小时 |
重要:
在没有用户活动发生时,理想情况下,您的应用至少90%的时间应在实用程序或更低的QoS级别运行。
在iPhone上,当启用低功耗模式时,裁量和后台操作,包括网络连接,会被暂停。请参见对iPhone上的低功耗模式做出响应
特殊 QoS 类别
| QoS 类别 | 描述 |
|---|---|
| Default 默认 |
优先级介于 User-initiated 和 Utility 之间。不供开发者直接使用——未指定 QoS 的工作默认归入此级别,GCD 全局队列也在此级别运行。 |
| Unspecified 未指定 |
表示缺少 QoS 信息,提示系统根据环境推断 QoS。使用老旧 API 的线程(可能已脱离 QoS 机制)会被赋予此级别。 |
共享数据
之前说过共享内存模式
在共享内存模式里,需要一种机制来协调多个线程共用的数据,通常使用同步机制来实现这一目标,例如使用锁或者判定条件
锁是一种控制多线程间数据访问和资源共享的机制
线程获得共享资源的锁,对该资源执行操作,接着释放这个锁,然后其他线程才能访问该资源。
条件变量是一种同步机制,它使线程一直处于等待状态直到指定条件出现,条件变量通常是使用锁来实现的
锁带来的问题
锁是最常见的控制机制,使用它可以控制多线程多共享数据的访问。
锁实施一种互斥策略从而避免受保护的数据和资源被多个线程同时访问
遗憾的是,在使用锁协调对共享数据的访问时,很可能引发死锁,活锁,资源匮乏等问题,这些问题都会导致程序中断
死锁是指两个或多个线程相互阻塞的情况,每个线程都在等待其他线程释放锁,导致所有线程都一直处于等待状态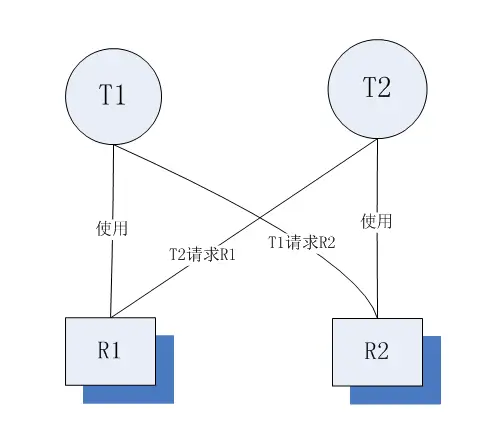
活锁是指一个线程因为要回应其他的一个或多个线程,而导致自身无法继续执行的情况。活锁的线程没有被阻塞,它将所有的计算时间用于回应其他线程,以恢复正常的操作
资源匮乏是指线程无法正常访问共享资源的情况,其原因通常是共享资源被其他线程占用
当一个或者多个线程占用共享资源时间过长的时候,就会引发这种问题。实际上可以看出,活锁可以被视为资源匮乏的一种形式
一些常用处理方式如下:
- 实现获取锁的总次序:确保进程按照固定次序获取和释放锁。这种处理方式需要掌握线程代码相关的知识,而且可能无法应用于第三方软件
- 防止出现保持和等待条件:使线程一次原子获取所有的锁。这可以确保在任何时候每个线程都拥有一个锁,从而使程序获得了全局的预防锁,这种处理方式消除了出现保持和等待的可能性,但可能会降低并发处理的效率,而且需要掌握线程代码的知识
- 提供优先权:使用提供试锁(trylock)或者类似机制的锁,如果可以,获取锁;如果不行,返回一个合适的结果。这种处理方式会增加出现活锁的可能性,而且需要掌握代码如何使用锁的知识
- 设置等待超时:使用提供超时功能的锁,防止出现无限等待的情况
消息传递
在消息传递方式,模型状态不是共享的,线程通过交换信息进行通信。这种处理方式使线程能够通过交换消息进行同步和通信
消息传递避免了互斥问题,并自然地与多核多处理器系统契合。使用消息传递,既可以执行同步通信,也可以执行异步通信。
在进行同步消息传递时,发送者和接收者会直接连接,消息传递完成后,发送者和接收者会断开连接;异步消息传递则通过队列传输消息。
消息不是在进程之间直接传递,而是通过消息队列进行交换。
因此,发送者和接收者并不会排队。发送者将消息发送给队列后,也无需断开连接。
使用异步消息传递可以实现并发编程
在Objective-C中实现并发编程
前面介绍了一些与并行编程有关的关键问题,下面探讨如何在 Objective-C 中实现并发编程。内容从语言特性到 API 与系统服务,包括以下几条:
- 语言特性:OC语言有多个支持并发编程的特性,使用
@synchronized指令可以在OC代码中创建锁。使用atomic属性限定符可以对OC属性进行线程安全的访问 - 消息传递:Foundation框架中的NSObject类含有多个用于向其他线程发送消息的方法。这些方法会将目标线程运行循环中的消息添加入队列中,而且能够通过同步或异步的方式执行
- 线程:Foundation框架提供了直接创建和管理线程的整套API,其中包括了对于多线程共享数据进行同步访问的Foundation框架API集
- 操作队列:这是基于OC的消息传递机制,它通过异步设计方法实现并发编程
- 分派队列:这些是基于C语言的一系列语言特性和运行时服务,用于通过异步和并发方式执行任务
语言特性
synchronized
概述和使用场景
@synchronized指令提供了在Objective-C代码中创建锁的简单机制,使并发线程能够同步访问共享状态
语法如下:
@synchronized(uniqueObj) {
// 被该指令保护的代码
}@synchronized指令后带有一个唯一标识符,即圆括号后
这是一个用于区分受保护代码块的对象
如果有多个线程尝试使用相同的唯一标识符访问这个关键部分,那么这些线程的某一个线程会先得到锁,而其他线程会被阻塞,直到锁的线程完成对这个关键部分的操作为止
凡是拿这个同一个对象当锁标识的代码,都必须排队执行;不同对象的代码互不影响
例如一个公司有A,B两个会议室,则圆括号内的就是不同的会议室。
会议室内,如果有两个人同时发言,则一方必须要等待另一方发言完毕
但是如果在会议室外,则无所谓,A会议室的发言不可能因为B会议室有人在说话而停止
这种修饰符一般用于多个线程可能同时读写同一份可变数据,或者一次要同时更新多个关联字段的情况
内部标识符
关于内部的标识符,有几点需要强调
关于之前的会议室的例子
如果现在A,B会议室都在开会,而两个会议室开会的中心都是与会议室C有关。
A会议室要改进C,而B会议室要拆除C
由于标识符不一样,二者都可以下决定,导致会议室C处于一种叠加态(?)
这个时候,标识符就不应该设置为A,B了,而是应该设置一个与C相关的对象
即:锁该选谁,不看代码在哪个“会议室”执行,而看它们共同会改到哪个资源。
在一般的使用中,通常会在类内创建一个私有类,用来管理锁
atomic修饰符
OC语言还提供了一种用于对属性进行原子访问的特性,原子属性限定符是一种OC语言特性,专门用于提供对属性的原子访问,即使其访问方法被多个线程同时调用,他也能发挥作用
原子是指不论属性是否被以并发方式访问,属性的访问方法永远都会设置/获取完整的(一致的)值
在默认情况下,OC的属性都是原子的,因此无需专门在属性声明语句中使用atomic关键字
注意!!!
原子属性限定符为属性提供了原子访问方式,但是没有提供线程安全性
原子属性限定符只能保证你的单次操作,即为你的属性赋值或者读取某个属性不被拆开
线程安全性则需要你保证整段相关操作都不能有人来干扰
之后我们会在GCD里举出这么一个例子
消息传递
Foundation框架中的NSObject类含有很多方法,这些方法使用消息传递模式,通过线程调用对象的方法,该线程可以是现存的次要线程,也可以是主应用程序线程,下面是方法的参数列表:
- (void)performSelectorOnMainThread:(SEL)aSelector withObject:(nullable id)arg waitUntilDone:(BOOL)wait modes:(nullable NSArray<NSString *> *)array NS_SWIFT_UNAVAILABLE_FROM_ASYNC("Work intended for the main actor should be marked with @MainActor");

- (void)performSelectorOnMainThread:(SEL)aSelector withObject:(nullable id)arg waitUntilDone:(BOOL)wait NS_SWIFT_UNAVAILABLE_FROM_ASYNC("Work intended for the main actor should be marked with @MainActor");
	// equivalent to the first method with kCFRunLoopCommonModes

- (void)performSelector:(SEL)aSelector onThread:(NSThread *)thr withObject:(nullable id)arg waitUntilDone:(BOOL)wait modes:(nullable NSArray<NSString *> *)array API_AVAILABLE(macos(10.5), ios(2.0), watchos(2.0), tvos(9.0)) NS_SWIFT_UNAVAILABLE_FROM_ASYNC("Asynchronous work should be called from isolation from an actor");

- (void)performSelector:(SEL)aSelector onThread:(NSThread *)thr withObject:(nullable id)arg waitUntilDone:(BOOL)wait API_AVAILABLE(macos(10.5), ios(2.0), watchos(2.0), tvos(9.0)) NS_SWIFT_UNAVAILABLE_FROM_ASYNC("Asynchronous work should be called from isolation from an actor");
	// equivalent to the first method with kCFRunLoopCommonModes

- (void)performSelectorInBackground:(SEL)aSelector withObject:(nullable id)arg API_AVAILABLE(macos(10.5), ios(2.0), watchos(2.0), tvos(9.0));


  // 更适合中国宝宝的阅读
  [object performSelector:<#(nonnull SEL)#>
                 onThread:<#(nonnull NSThread *)#>
               withObject:<#(nullable id)#>
            waitUntilDone:<#(BOOL)#>];

  [object performSelector:<#(nonnull SEL)#>
                 onThread:<#(nonnull NSThread *)#>
               withObject:<#(nullable id)#>
            waitUntilDone:<#(BOOL)#>
                    modes:<#(nullable NSArray<NSString *> *)#>];

  [object performSelectorOnMainThread:<#(nonnull SEL)#>
                           withObject:<#(nullable id)#>
                        waitUntilDone:<#(BOOL)#>];

  [object performSelectorOnMainThread:<#(nonnull SEL)#>
                           withObject:<#(nullable id)#>
                        waitUntilDone:<#(BOOL)#>
                                modes:<#(nullable NSArray<NSString *> *)#>];

  [object performSelectorInBackground:<#(nonnull SEL)#>
                           withObject:<#(nullable id)#>];
| 参数 | 含义 |
|---|---|
performSelector: |
要调用的方法名,使用 @selector(方法名)。例如 @selector(updateUI) 或 @selector(process:)。 |
onThread: |
指定在哪个 NSThread 上执行。例如 [NSThread mainThread] 是主线程。 |
withObject: |
传给目标方法的参数;只能传 一个对象参数,不需要参数时传 nil。目标方法通常写成 - (void)process:(id)obj。 |
waitUntilDone: |
是否等待方法执行完成。YES:当前线程会阻塞等待;NO:立即返回、异步执行。通常不要在主线程中随意用 YES,可能卡住界面或造成死锁。 |
modes: |
指定目标线程 Run Loop 在哪些运行模式下接收并执行该调用。一般传 @[\[NSRunLoopCommonModes\]] 或 nil;nil 通常等同于默认运行模式。 |
| 对于主线程或者系统负责管理的线程来说,autoreleasepool会在每个事件循环或任务周围自动建立自动释放池 | |
| 但是对于自己建立的线程来说,未必有持续可用的自动释放池 | |
| 所以你调用的SEL方法应该这样实现 |
- (void)downloadTask {
  @autoreleasepool {
   // 进行操作
  }
}| 方法 | 执行线程 | 一般是否手动加 @autoreleasepool |
|---|---|---|
performSelector:onThread:... |
你传入的 NSThread |
通常不需要;前提是该线程正在运行 RunLoop。若是自己创建的工作线程、长循环或批处理,目标方法内部应按任务或循环加池 |
performSelectorOnMainThread:... |
主线程 | 通常不需要;主线程 RunLoop 会维护自动释放池 |
performSelectorInBackground:withObject: |
系统新建的后台线程 | 建议在目标方法中加,尤其有循环、大量临时对象或耗时任务时 |
线程
如之前所说,线程是指在某个进程环境中执行的逻辑控制流。OS X和iOS操作系统为线程的创建,管理,执行提供了直接的支持。在应用层,Foundation框架提供了许多用于创建和管理线程的的API,以及用于在并发线程之间同步共享数据访问的API集合
四种多线程方案的总览
在展开各个 API 之前,先把 iOS 上的四种多线程方案摆在一起。它们不是并列关系,而是层层封装的关系:
NSOperation / NSOperationQueue     ← 基于 GCD 封装
        ↓
GCD (libdispatch)                  ← 基于 pthread 封装
        ↓
NSThread                           ← 基于 pthread 封装
        ↓
pthread (POSIX threads) ← C 语言 API,直接对应内核线程| 方案 | 语言 | 线程生命周期 | 特点 | 使用频率 |
|---|---|---|---|---|
| pthread | C | 手动管理 | 跨平台(POSIX 标准),最底层,使用最繁琐 | 几乎不直接用 |
| NSThread | OC | 手动管理 | 面向对象,可直接操作线程对象,能设置名称、栈大小、优先级 | 少用,主要用于线程保活 |
| GCD | C | 自动管理 | 基于队列,自动使用线程池,API 丰富 | 最常用 |
| NSOperation | OC | 自动管理 | GCD 的面向对象封装,支持依赖、取消、KVO、并发数控制 | 复杂任务管理时使用 |
面试标准答法:底层都是 pthread;NSThread 和 GCD 是它的两种封装方向(前者面向线程、后者面向队列);NSOperation 又是 GCD 的封装。越往上越易用,越往下越可控。日常开发用 GCD,需要依赖/取消/并发数控制时用 NSOperation,线程保活时用 NSThread。
pthread
pthread 是 POSIX 标准定义的一套 C 语言线程 API,是所有上层方案的地基。它跨平台(Linux、Unix、Android 都能用),但在 iOS 上直接使用非常繁琐:
#import <pthread.h>

void *taskEntry(void *param) {
    @autoreleasepool {            // 必须自己管理自动释放池
        NSLog(@"在子线程执行:%@", [NSThread currentThread]);
    }
    return NULL;
}

- (void)startPthread {
    pthread_t thread;
    // 参数:线程句柄、线程属性(NULL 为默认)、入口函数、传给入口函数的参数
    int result = pthread_create(&thread, NULL, taskEntry, NULL);

    if (result == 0) {
        pthread_detach(thread);   // 分离线程,结束后自动回收资源
        // 或 pthread_join(thread, NULL); 阻塞等待线程结束
    }
}
它的问题很明显,也正是上层方案存在的理由:
- 线程生命周期全部手动管理,必须自己
detach或join,否则资源泄漏; - 没有自动释放池,必须在入口函数里自己写
@autoreleasepool; - 参数只能传
void *,需要手动做类型转换; - 没有任何任务调度能力,想复用线程得自己实现线程池。
实际开发中唯一会真正碰到 pthread 的地方,是它提供的同步原语——pthread_mutex、pthread_rwlock、pthread_cond。因为 Foundation 没有封装读写锁,用读写锁只能直接调 POSIX API。这部分详见后面“锁的底层原理”一章。
NSObject线程
在语言传递一章中,说到过performSelectorInBackground:withObject方法,可以隐式的创建和启动用于执行对象中方法的新线程。该线程会作为后台次要进程立刻启动,而当前进程会立刻返回
这个方法提供了一种使用新后台线程执行对象中方法的简单机制。
该线程实例是隐式创建的,无需使用API。需要根据需要,在方法中配置该线程的环境(如自动释放池等)
NSThread
NSThread类提供了用于显式创建和管理线程的API,这个类有很多方法来创建初始化其实例对象,启动和停止线程,配置线程和查询线程及其执行环境
一些API如下:
+ detachNewThreadSelector:<#(nonnull SEL)#> toTarget:<#(nonnull id)#> withObject:<#(nullable id)#>;

- initWithTarget:<#(nonnull id)#> selector:<#(nonnull SEL)#> object:<#(nullable id)#>;
这两个方法的作用基本上一目了然
类方法detachNewThreadSelector:toTarget:withObject:会创建一个新线程,并调用你给出的方法,从功能上来讲detachNewThreadSelector:toTarget:withObject:与performSelectorInBackground:withObject:;等价
与之不同的是,initWithTarget:selector:object:;会创建新线程,但是不会启动该线程。当已经初始化的线程开始执行方法时,NSThread类中的启动方法就会被调用
// 创建要执行任务的对象
ConcurrentProcessor *processor = [ConcurrentProcessor new];
// 创建线程并指定任务
NSThread *computerThread = [[NSThread alloc] initWithTarget:processor                                                    selector:@selector(computeTask)
                                                     object:nil];
// 设置线程优先级
[computerThread setThreadPriority:0.5];
// 真正启动线程
[computerThread start];
代码展示了使用初始化方法创建并初始化新的 NSThread 实例的情况。该方法设置了选择器、目标接收器的实例和可用入口点历程参数的对象
这个方法会返回已初始化的 NSThread 实例,因此可以在调用 start 方法前使用它配置线程。
如之前所讲述的,NSThread 类的 API 还有许多其他方法。使用这些方法可以配置线程、确定线程的执行状态、查询线程的环境。
这时你能够设置线程的优先级、栈大小和线程字典,检索当前线程和调用栈信息,暂停线程以及执行一些其他操作,例如暂停五秒
[NSThread sleepForTimeInterval:5.0]; // 将当前线程暂停 5s线程同步
如果你打算使用线程实现并发编程,OC平台提供了多种机制来管理共享状态和实现线程之间的同步,尤其是Foundation框架中含有一系列锁和条件变量API,它们以面向对象的方式实现了这些机制,下面详细介绍
锁
事实上锁这个重要的东西是应该单独开一章的,但是归功能的话还是得归到这里
Foundation框架含有多个类(NSLock,NSRecursiveLock,NSConditionLock,NSDistributedLock)使用这些类可以实现各种用于控制同步访问共享状态的锁。锁用于保护关键部分(即用于访问共享数据或者资源的代码部分),这些代码不允许用多个线程以并发的方式执行
| 锁 | 说明 |
|---|---|
| Mutex | 互斥(mutually exclusive,简称 mutex)锁充当资源周围的一道保护屏障。mutex 是一种信号量,一次只授予一个线程访问权限。如果某个 mutex 正在使用中,而另一个线程试图获取它,该线程就会阻塞,直到原来持有该 mutex 的线程将其释放为止。如果多个线程争用同一个 mutex,一次也只允许一个线程访问它。 |
| Recursive lock(递归锁) | 递归锁是互斥锁的一种变体。递归锁允许同一个线程在释放锁之前多次获取该锁。其他线程会一直保持阻塞,直到该锁的持有者以获取次数相同的次数释放该锁为止。递归锁主要用于递归迭代过程中,但也可以用于多个方法各自都需要单独获取该锁的情况。 |
| Read-write lock(读写锁) | 读写锁也被称为共享-互斥(shared-exclusive)锁。这类锁通常用于较大规模的操作,如果被保护的数据结构经常被读取、只是偶尔被修改,读写锁能显著提升性能。在正常操作期间,多个读取者可以同时访问该数据结构。不过,当某个线程想要写入该结构时,它会阻塞,直到所有读取者都释放锁为止,此时它才会获取该锁并可以更新该结构。当一个写入线程正在等待该锁时,新的读取线程会阻塞,直到该写入线程完成为止。系统仅支持使用 POSIX 线程实现读写锁。有关如何使用这些锁的更多信息,请参阅 pthread man 手册页。 |
| Distributed lock(分布式锁) | 分布式锁在进程级别提供互斥访问。与真正的 mutex 不同,分布式锁不会阻塞某个进程或阻止其运行。它只是报告该锁是否正忙,并让进程自行决定如何处理。 |
| Spin lock(自旋锁) | 自旋锁会反复轮询其加锁条件,直到该条件变为真为止。自旋锁最常用于多处理器系统中锁的预期等待时间很短的场合。在这些情况下,轮询往往比阻塞线程更高效,因为阻塞线程涉及上下文切换和线程数据结构的更新。由于自旋锁具有轮询的性质,系统不提供任何自旋锁的实现,但你可以很方便地在特定场景中自行实现它们。有关在内核中实现自旋锁的信息,请参阅 内核编程指南。 |
| Double-checked lock(双重检查锁) | 双重检查锁试图通过在加锁之前先测试加锁条件,来减少加锁的开销。由于双重检查锁具有潜在的不安全性,系统不为其提供明确的支持,也不建议使用这种锁。 |
NSLock
NSLock类为并发编程实现了一种基本的互斥锁。它遵循NSLocking协议,并因此会实现分别用于获取和释放锁的 lock 和 unlock 方法
之前介绍过@synchronized,它是一种语言特性,可以实现媲美NSLock的互斥锁
这两种创建方式之间有两个主要差异:
@synchronized指令隐式创建锁,而NSLock的API直接创建锁@synchronized指令会隐式的为关键部分提供异常处理程序,而NSLock类没有提供这一功能
NSLock *computerLock = [NSLock new];

[computerLock lock]; // 如果锁已经被其他线程占用,会在这里等待
// 临界区:需要保证线程安全的代码
[computerLock unlock];
注意事项
lock和unlock必须成对出现;忘记unlock会导致其他线程一直等待,形成死锁。- 不要在同一线程里连续对同一个
NSLock调用两次lock。NSLock不可重入,第二次会卡住自己。 - 可能发生异常或提前
return时,建议用@try/@finally保证解锁
NSDistributedLock
NSDistributedLock类定义了一个可由多台主机上的多个应用程序使用的锁,使用该锁可以控制对共享资源的访问操作
它的主要适用场景基本为多个进程之间的通信,而不仅仅是一个进程中的多个线程
与NSLock类不同,NSDistributedLock实例对于互斥策略比较宽松,它会返回一个结果,来表示是否占用
它没有遵守NSLocking协议,而且,因为这个锁是使用文件系统实现的,所以它没有lock方法
可惜,这个锁不支持iOS,为Mac Catalyst 13.0+macOS 10.0+
NSConditionLock
NSConditionLock定义了一种只有在特定条件下才能被获取和释放的锁,这个条件是由你定义的整数值。条件锁通常用于确保任务以指定的顺序执行
与NSLock不同的地方在于,NSLock 通常关注的是这个锁当前有没有被其他线程占用,而条件锁除了查看这把锁是否是空闲的,还需要关注内部的condition是否等于我要求的值
NSConditionLock *conditionLock = [[NSConditionLock alloc] initWithCondition:0]; // 初始化NSConditionLock有两个关键方法
lockWhenCondition::只有“锁空闲,并且当前 condition 等于指定值”时,线程才能进入,否则会等待。
[lock lockWhenCondition:BufferStateEmpty];unlockWithCondition::完成操作后,把 condition 改成新值,同时释放锁。
[lock unlockWithCondition:BufferStateFull];NSRecursiveLock
NSRecursiveLock类提供了一种可以在不引起死锁的情况下,被同一个线程获取多次的锁,这种锁可以记录它被锁的次数,而在锁释放之前,必须用相应的调用语句进行平衡以解锁对象
可能目前这种锁的存在的意义不是很明确,也很难理解为什么这种锁可以被锁两次
可以这样理解。NSRecursiveLock 对“自己家人”——已经持有锁的同一个线程——允许重复进入;对“别人”——其他线程——仍然会挡在外面。
NSCondition
我们之前介绍过了 NSConditionLock。
现在我们来看一下 NSCondition——NSConditionLock 正是基于它构建的。
NSCondition 本质上是一个条件变量 + 互斥锁的合体。它遵循 NSLocking 协议(有 lock / unlock),但真正的能力在于让线程在条件不满足时休眠,等条件满足时被唤醒
它与普通锁的核心区别:
- 普通锁(如
NSLock):只管“能不能进临界区” NSConditionLock:在锁的基础上加了一个整数条件值,达到条件才能获取锁NSCondition:更底层——它不预设条件值的概念,而是让你自己定义“条件”,然后通过wait/signal来协调
关键方法
wait —— 当前线程进入等待状态,同时原子地释放锁。当被唤醒时,线程会重新获取锁,然后 wait 方法返回。
signal —— 唤醒一个正在 wait 的线程。如果没有线程在等待,信号被忽略。
broadcast —— 唤醒所有正在 wait 的线程。
工作流程
// 线程A(消费者)
[cocoaCondition lock];

while (timeToDoWork <= 0) {
    [cocoaCondition wait];  // 释放锁并休眠,直到被唤醒
}

timeToDoWork--;

// Do real work here.

[cocoaCondition unlock];

// 线程B(生产者)
[cocoaCondition lock];
timeToDoWork++;
[cocoaCondition signal];   // 唤醒一个等待线程
[cocoaCondition unlock];
线程A lock → 发现条件不满足 → wait(此时锁被释放,线程休眠)→ 线程B lock → 改变条件 → signal(唤醒线程A)→ 线程B unlock → 线程A醒来,重新获取锁 → wait 返回 → 继续执行。
为什么用 `while` 而不是 `if`
这是 NSCondition 使用中最容易被忽视的点。必须用 while,原因有二:
- 虚假唤醒:即使没有收到
signal,线程也可能被内核唤醒(spurious wakeup)。while保证了醒来后会再次检查条件,不满足就继续等。 - 条件被抢占:从被唤醒到重新获取锁之间有时间窗口。如果另一个线程先拿到锁并改变了条件(比如又让
timeToDoWork归零),那么当前线程拿到锁时条件已不再满足。while会让它继续等待。
简单说:if 只检查一次,while 每次醒来都再检查一次。后者才是安全的。
`signal` vs `broadcast`
signal:唤醒一个线程。适用于一个生产者、一个消费者场景。broadcast:唤醒所有等待线程。适用于条件变化后所有等待线程都应该重新评估的场景(比如某个全局状态由不可用变为可用)。
`NSCondition` 与 `NSConditionLock` 的关系
NSConditionLock 内部持有一个 NSCondition 实例,用它的 wait / signal 实现了基于整数值的条件等待。也就是说,NSConditionLock 是 NSCondition 的上层封装,帮你把“自己管理条件变量”简化为“比较一个整数”
操作和操作队列
操作对象(operation object)是 NSOperation 类的实例,用于封装你想要执行的工作。NSOperation 本身是一个抽象基类,必须子类化才能使用。但它已经内置了大量基础设施,帮你省掉了大量模板代码。此外,Foundation 提供了两个可以直接使用的具体子类。
所有操作对象都支持的关键功能
无论使用哪种具体子类,所有操作对象都共享以下能力:
- 基于图的依赖关系:可以建立操作之间的依赖,某个操作在其依赖的所有操作完成之前不会运行
- 可选的完成回调 block:操作的主任务完成后执行
- 通过 KVO 监控操作的执行状态变化
- 操作优先级与 QoS,影响相对执行顺序
- 取消语义,允许在执行中终止操作
三种操作类
| 类 | 描述 |
|---|---|
| NSInvocationOperation | 基于已有的对象和 selector 创建操作,不需要子类化。适用于已有现成方法能完成任务、想快速封装成操作的场景。也可以动态选择 selector。 |
| NSBlockOperation | 并发执行一个或多个 block,使用组语义——所有 block 都执行完毕,操作才算完成。初始化时可添加 block,之后可通过 addExecutionBlock: 追加。适用于任务逻辑简单、不想单独建类,或需要把多个小任务打包成一个操作时。 |
| NSOperation | 抽象基类。通过子类化可完全控制操作的执行方式、状态报告、依赖管理等。 |
NSInvocationOperation 和 NSBlockOperation 都是 NSOperation 的子类。大多数情况下 NSBlockOperation 更灵活,NSInvocationOperation 主要为了兼容老旧代码。
NSOperationQueue
操作本身定义的是"做什么",而操作队列决定"何时做、怎么做"。NSOperationQueue 管理操作的调度与并发执行。
创建队列:
NSOperationQueue *queue = [[NSOperationQueue alloc] init];添加操作:
// 添加一个操作对象
[queue addOperation:operation];

// 直接用一个 block 创建并添加
[queue addOperationWithBlock:^{
    // 执行任务
}];
控制并发数:
queue.maxConcurrentOperationCount = 4;  // 同时最多执行 4 个操作
// 设为 1 则为串行队列
maxConcurrentOperationCount 默认值为 NSOperationQueueDefaultMaxConcurrentOperationCount,由系统根据当前条件自动决定并发数。
队列状态控制:
queue.suspended = YES;       // 暂停队列(已在执行的操作不受影响)
queue.suspended = NO;        // 恢复

[queue cancelAllOperations]; // 取消所有操作
[queue waitUntilAllOperationsAreFinished]; // 阻塞当前线程直到所有操作完成
获取主队列:
NSOperationQueue *mainQueue = [NSOperationQueue mainQueue];主队列在应用主线程上串行执行操作,用于更新 UI。
获取当前队列:
NSOperationQueue *currentQueue = [NSOperationQueue currentQueue];队列的 QoS:
queue.qualityOfService = NSQualityOfServiceUserInitiated;队列的 QoS 会覆盖其中操作的 QoS。如果操作和队列属于不同 QoS 级别,系统会以更高者为准。
并发操作 vs 非并发操作
虽然通常通过操作队列来执行操作,但你也可以手动调用 start 方法直接执行。isAsynchronous 方法告诉你在调用 start 的线程中,操作是同步还是异步执行的。默认返回 NO,意味着操作在调用线程中同步执行。
旧版 API 使用
isConcurrent,该属性在 iOS 8 / macOS 10.10 起被标记为废弃,改为isAsynchronous。二者语义完全相同,新代码应使用isAsynchronous。
如果你想实现并发操作——即相对于调用线程异步运行——你需要写额外代码来异步启动操作,比如创建独立线程或调用异步系统函数。
大多数开发者不需要实现并发操作。
如果你总是把操作添加到操作队列中,就不需要实现并发操作。
当你把非并发操作提交给操作队列时,队列本身会创建线程来运行你的操作。因此,把非并发操作加入队列仍然能实现异步执行。
只有当你需要在不加入队列的情况下手动异步执行操作时,才需要定义并发操作。
创建 NSInvocationOperation
NSInvocationOperation 是 NSOperation 的具体子类,运行时会在你指定的对象上调用你指定的 selector。适用于已有现成对象和方法、不想为每个任务定义大量自定义操作类的场景。
@implementation MyCustomClass
- (NSOperation*)taskWithData:(id)data {
    NSInvocationOperation* theOp = [[NSInvocationOperation alloc] initWithTarget:self selector:@selector(myTaskMethod:) object:data];

    return theOp;
}

// 实际执行任务的方法
- (void)myTaskMethod:(id)data {
    // 执行任务
}
@end
创建 NSBlockOperation
NSBlockOperation 是 NSOperation 的具体子类,作为一个或多个 block 的包装器。它提供了面向对象的封装,让你可以利用操作依赖、KVO 通知等特性。
创建 block 操作时,初始化时通常至少添加一个 block,后续可按需追加。执行时,对象将所有 block 提交到默认优先级的并发 dispatch 队列,然后等待所有 block 执行完毕。最后一个 block 完成后,操作对象标记自身为已完成。
NSBlockOperation* theOp = [NSBlockOperation blockOperationWithBlock: ^{
    NSLog(@"Beginning operation.\n");
    // Do some work.
}];
创建后可通过 addExecutionBlock: 追加更多 block。如果需要串行执行 block,必须直接提交到目标 dispatch 队列。
自定义 NSOperation 子类
如果 block operation 和 invocation operation 无法满足需求,可以直接子类化 NSOperation 并添加所需行为。NSOperation 提供了大量基础设施来处理依赖和 KVO 通知,但有时仍需补充一些代码。额外工作量的多少取决于你实现的是非并发操作还是并发操作。
定义非并发操作比定义并发操作简单得多。对于非并发操作,只需执行主任务并正确响应取消事件即可。对于并发操作,则需要用自定义代码替换部分现有基础设施。
执行主任务
每个操作对象至少应实现以下方法:
- 自定义初始化方法
main方法
可选实现:从 main 中调用的自定义方法、用于设置数据和访问结果的存取方法、NSCoding 协议方法。
@interface MyNonConcurrentOperation : NSOperation
@property id (strong) myData;
-(id)initWithData:(id)data;
@end

@implementation MyNonConcurrentOperation
- (id)initWithData:(id)data {
    if (self = [super init])
        myData = data;
    return self;
}

-(void)main {
    @try {
        // 对 myData 进行操作并报告结果
    }
    @catch(...) {
        // 不要重新抛出异常
    }
}
@end
响应取消事件
操作开始执行后,会持续运行直到完成或被显式取消。取消可以随时发生,甚至在操作开始执行之前。操作对象需要定期检查取消事件,并在操作中途收到取消时优雅退出。
要支持取消,只需在自定义代码中定期调用 isCancelled 方法,一旦返回 YES 就立即返回。isCancelled 非常轻量,可以频繁调用。建议在以下位置检查:
- 执行任何实际工作之前
- 循环的每次迭代中至少一次,如果每次迭代较长则更频繁
- 代码中任何容易中止操作的位置
- (void)main {
    @try {
        BOOL isDone = NO;
        while (![self isCancelled] && !isDone) {
            // 执行一些工作,完成时将 isDone 设为 YES
        }
    }
    @catch(...) {
        // 不要重新抛出异常
    }
}
配置并发操作
操作对象默认以同步方式执行——在调用 start 的线程中执行任务。如果你想手动执行操作并使其异步运行,需要定义并发操作。
实现并发操作需要重写的方法:
| 方法 | 说明 |
|---|---|
start |
必须。所有并发操作必须重写此方法,用自定义实现替换默认行为。你的实现是操作的起点,负责设置线程或其他执行环境。实现中绝不能调用 super。 |
main |
可选。通常用于实现操作关联的任务。虽然在 start 中也可以执行任务,但用 main 可以让设置代码和任务代码分离得更清晰。 |
isExecuting / isFinished |
必须。并发操作负责设置自己的执行环境并报告状态。因此必须维护状态信息,并通过这两个方法报告。实现必须能从其他线程安全调用,且值变化时必须生成对应的 KVO 通知。 |
isAsynchronous |
必须。重写并返回 YES 以标识为并发操作。旧版名称 isConcurrent 已废弃。 |
下面是并发操作的基础实现(使用 GCD 在后台执行 main):
@interface MyOperation : NSOperation {
    BOOL        executing;
    BOOL        finished;
}
- (void)completeOperation;
@end

@implementation MyOperation
- (id)init {
    self = [super init];
    if (self) {
        executing = NO;
        finished = NO;
    }
    return self;
}

- (BOOL)isAsynchronous {
    return YES;
}

- (BOOL)isExecuting {
    return executing;
}

- (BOOL)isFinished {
    return finished;
}

- (void)start {
    // 启动前始终检查是否已取消
    if ([self isCancelled]) {
        [self willChangeValueForKey:@"isFinished"];
        finished = YES;
        [self didChangeValueForKey:@"isFinished"];
        return;
    }

    [self willChangeValueForKey:@"isExecuting"];
    executing = YES;
    [self didChangeValueForKey:@"isExecuting"];

    dispatch_async(dispatch_get_global_queue(DISPATCH_QUEUE_PRIORITY_DEFAULT, 0), ^{
        [self main];
    });
}

- (void)main {
    @try {
        // 执行操作的主要工作
        [self completeOperation];
    }
    @catch(...) {
        // 不要重新抛出异常
    }
}

- (void)completeOperation {
    [self willChangeValueForKey:@"isFinished"];
    [self willChangeValueForKey:@"isExecuting"];

    executing = NO;
    finished = YES;

    [self didChangeValueForKey:@"isExecuting"];
    [self didChangeValueForKey:@"isFinished"];
}
@end
现代实践中,通常用 GCD
dispatch_async取代NSThread detachNewThreadSelector:来启动并发操作的后台任务。GCD 更轻量,且能复用线程池。
即使操作被取消,也必须通知 KVO 观察者操作已完成。当某个操作依赖其他操作完成时,它会监控那些对象的 isFinished 键路径。只有所有对象都报告完成,依赖操作才会标记为就绪。不发送完成通知会阻止其他操作的执行。
保持 KVO 合规
NSOperation 类对以下键路径是 KVO 合规的:isCancelled、isAsynchronous、isExecuting、isFinished、isReady、dependencies、queuePriority、completionBlock。
如果你重写 start 方法或对 NSOperation 做了除重写 main 之外的重大定制,必须确保自定义对象对这些键路径保持 KVO 合规。重写 start 时最常受影响的是 isExecuting 和 isFinished。
如果使用
@property声明executing和finished并通过属性存取(而非手动willChangeValueForKey:/didChangeValueForKey:),编译器会自动合成 KVO 通知,代码可以省掉一大半。手动写法如上面示例所示,面试时两种都可能被问到。
配置操作行为
操作的配置发生在创建之后、添加到队列之前。以下配置适用于所有操作对象。
配置操作间依赖
依赖用于串行化不同操作对象的执行。一个依赖于其他操作的操作,必须在它依赖的所有操作完成后才能运行。
[operationB addDependency:operationA]; // operationB 将在 operationA 完成后才执行依赖不限于同一队列中的操作。操作对象管理自己的依赖,因此可以在不同队列的操作之间建立依赖。注意不要创建循环依赖,这会导致死锁。
修改执行优先级与 QoS
对于添加到队列中的操作,执行顺序由已就绪操作的优先级和依赖关系共同决定。你需要通过 setQueuePriority: 设置优先级,可选的优先级级别从低到高依次为:
NSOperationQueuePriorityVeryLowNSOperationQueuePriorityLowNSOperationQueuePriorityNormalNSOperationQueuePriorityHighNSOperationQueuePriorityVeryHigh
优先级仅适用于同一队列中的操作。如果应用有多个操作队列,每个队列独立确定自己操作的优先级。
iOS 8 起,NSOperation 新增了 qualityOfService 属性,直接映射到前面讲过的 QoS 等级:
operation.qualityOfService = NSQualityOfServiceUserInitiated;NSQualityOfServiceUserInteractiveNSQualityOfServiceUserInitiatedNSQualityOfServiceUtilityNSQualityOfServiceBackgroundNSQualityOfServiceDefault
在同时设置了 queuePriority 和 qualityOfService 的情况下,qualityOfService 的影响权重更高。现代开发中,优先使用 qualityOfService。
设置完成回调
你可以设置一个完成 block,在操作的主任务完成后执行。
operation.completionBlock = ^{
    NSLog(@"操作完成!");
};
完成 block 是在操作对象标记为已完成之后、从操作队列中移除之前调用的。完成 block 中不应执行大量工作,且不应阻塞。
GCD
Grand Central Dispatch(GCD)是基于 C 语言的并发 API,通过 dispatch queue 管理任务调度。与 NSOperationQueue 相比,GCD 更轻量,适合大多数日常异步场景。NSOperationQueue 的优势在于依赖、取消和 KVO——不需要这些时,GCD 更简洁。
获取队列
系统提供两类标准队列:
// 主队列:主线程上的串行队列,所有 UI 更新必须回到这里
dispatch_queue_t mainQueue = dispatch_get_main_queue();

// 全局并发队列:系统维护的线程池,多个任务并发执行
dispatch_queue_t globalQueue = dispatch_get_global_queue(QOS_CLASS_DEFAULT, 0);
iOS 8 起,旧式
dispatch_get_global_queue(DISPATCH_QUEUE_PRIORITY_*, 0)已被 QoS 参数取代,新代码应使用上面的形式。第二个参数保留给未来扩展,始终传0。
创建自定义队列
// 串行队列:同时只执行一个任务,常用于保护共享资源
dispatch_queue_t serialQueue = dispatch_queue_create("com.example.serial", DISPATCH_QUEUE_SERIAL);

// 并发队列:同时执行多个任务,完成顺序不确定
dispatch_queue_t concurrentQueue = dispatch_queue_create("com.example.concurrent", DISPATCH_QUEUE_CONCURRENT);
第二个参数传 NULL 等同于 DISPATCH_QUEUE_SERIAL。队列名用于调试(Instruments / crash log 中可见),建议用反向域名格式。
创建时指定 QoS:
dispatch_queue_attr_t attr = dispatch_queue_attr_make_with_qos_class(
    DISPATCH_QUEUE_SERIAL, QOS_CLASS_UTILITY, -1);
dispatch_queue_t queue = dispatch_queue_create("com.example.qos", attr);
dispatch_set_target_queue也可以修改已有队列的优先级,或者将多个队列统一串行化,见本小节末尾。
dispatch_async / dispatch_sync
| 函数 | 行为 |
|---|---|
dispatch_sync(queue, block) |
同步提交。阻塞当前线程,等待 block 执行完毕后返回。 |
dispatch_async(queue, block) |
异步提交。立即返回,block 在目标队列上异步执行。 |
最常见的模式:后台干活,主线程更新 UI。
dispatch_async(dispatch_get_global_queue(QOS_CLASS_DEFAULT, 0), ^{
    // 耗时操作:网络请求、文件读写、大数据处理
    id result = [self doHeavyWork];

    dispatch_async(dispatch_get_main_queue(), ^{
        // 回到主线程更新界面
        self.label.text = result;
    });
});死锁陷阱:在串行队列上执行的代码,如果 dispatch_sync 到同一个串行队列,必然死锁。
根本原因很简单。串行队列一次只执行一个任务——当前任务还没执行完,就丢了一个新任务进去并要求"同步等结果"。队列要等当前任务结束才能调度新任务,当前任务又在等新任务完成才能继续。互相等待,谁都走不动。
场景一:主线程 sync 到自己
// 这段代码在主线程(主队列)上执行
dispatch_sync(dispatch_get_main_queue(), ^{
    NSLog(@"永远不会执行");
});
主队列当前正在执行这段代码 → dispatch_sync 提交了一个新的 block 到主队列并阻塞等待 → 主队列必须等当前任务执行完才能调度新 block → 当前任务在等新 block 完成 → 死锁。
场景二:自定义串行队列 sync 到自己
dispatch_queue_t queue = dispatch_queue_create("serial", DISPATCH_QUEUE_SERIAL);

dispatch_async(queue, ^{
    // 当前在 queue 上执行
    dispatch_sync(queue, ^{
        NSLog(@"同样永远不会执行");
    });
});
和主线程同理——只要是同一个串行队列,嵌套 dispatch_sync 必死。
场景三:跨队列也可能死锁(锁互斥引起)
GCD 的死锁不一定都是"sync 到自己的队列"。如果两个队列的任务相互等待,也会死锁,本质是对资源的竞争:
dispatch_queue_t queueA = dispatch_queue_create("A", DISPATCH_QUEUE_SERIAL);
dispatch_queue_t queueB = dispatch_queue_create("B", DISPATCH_QUEUE_SERIAL);

dispatch_async(queueA, ^{
    dispatch_sync(queueB, ^{  // ① queueA 的任务在等 queueB
        // ...
    });
});

dispatch_async(queueB, ^{
    dispatch_sync(queueA, ^{  // ② queueB 的任务在等 queueA
        // ...
    });
});
① 在等 queueB 上的任务执行完,② 在等 queueA 上的任务执行完。两者互相等待。
场景四:信号量在串行队列上等待自己是更隐蔽的变体
dispatch_semaphore_t sema = dispatch_semaphore_create(0);

dispatch_async(queue, ^{
    // 在串行队列上执行
    dispatch_semaphore_wait(sema, DISPATCH_TIME_FOREVER); // 等待信号
});

dispatch_semaphore_signal(sema); // 这个 signal 可能在 wait 之前就发了
这个不算死锁,但如果 signal 在 wait 之前就到达(且信号量没有被保留),wait 会永远等下去。
如何避免
- 在任何串行队列上执行的代码中,永远不用
dispatch_sync提交到这个队列自身。 - 不确定当前在哪个队列时,宁愿用
dispatch_async——牺牲一点即时性,换取安全性。 - 跨队列同步时,画一下依赖图:有没有 A 等 B、B 等 A 的闭环。
- 如果确实需要"在当前线程安全地回到主线程",先判断当前是否已在主线程:
if ([NSThread isMainThread]) {
    block();
} else {
    dispatch_sync(dispatch_get_main_queue(), block);
}
dispatch_once
保证 block 在整个应用生命周期内只执行一次,常用于单例或一次性初始化。dispatch_once_t 必须是 static 或全局变量。
static dispatch_once_t onceToken;
dispatch_once(&onceToken, ^{
    // 仅执行一次
});
dispatch_after
延时一段时间后将任务提交到队列。注意:延时的是提交时间,不是执行时间——如果目标队列正忙,实际执行会更晚。
dispatch_after(dispatch_time(DISPATCH_TIME_NOW, (int64_t)(2.0 * NSEC_PER_SEC)),
               dispatch_get_main_queue(), ^{
    // 约 2 秒后执行
});时间单位:NSEC_PER_SEC 即一秒对应的纳秒数(1,000,000,000),dispatch_time(DISPATCH_TIME_NOW, n * NSEC_PER_SEC) = n 秒后提交。
dispatch_group
监听一组异步任务全部完成后统一回调。
dispatch_group_t group = dispatch_group_create();
dispatch_queue_t queue = dispatch_get_global_queue(QOS_CLASS_DEFAULT, 0);

dispatch_group_async(group, queue, ^{ /* 任务 A */ });
dispatch_group_async(group, queue, ^{ /* 任务 B */ });

dispatch_group_notify(group, dispatch_get_main_queue(), ^{
    // A、B 全部完成
});
如果任务本身是异步的(如网络请求),用 dispatch_group_enter / dispatch_group_leave 手动配对:
dispatch_group_enter(group);
[self fetchDataWithCompletion:^{
    dispatch_group_leave(group);
}];
enter 和 leave 必须成对,次数不等会导致 notify 永不触发(leave 少)或 crash(leave 多)。
dispatch_barrier_async
用于并发队列的读写同步。barrier 提交后,队列等当前所有任务执行完,然后独占执行 barrier 任务,期间不调度其他任务。完成后恢复并发。
// 读:可以并发
dispatch_async(concurrentQueue, ^{ /* 读 */ });
dispatch_async(concurrentQueue, ^{ /* 读 */ });

// 写:用 barrier 确保写入时无其他读写同时进行
dispatch_barrier_async(concurrentQueue, ^{ /* 写 */ });
注意:barrier 只在自定义并发队列上有效。全局队列上行为等同于普通 dispatch_async。
dispatch_semaphore
控制并发访问数量,或等待异步操作完成。
dispatch_semaphore_create(value)—— 初始值 = 最大并发数dispatch_semaphore_wait(sema, timeout)—— 信号量减 1,为负则阻塞dispatch_semaphore_signal(sema)—— 信号量加 1,唤醒一个等待线程
// 限制最多 3 个并发任务
dispatch_semaphore_t sema = dispatch_semaphore_create(3);
for (int i = 0; i < 100; i++) {
    dispatch_async(queue, ^{
        dispatch_semaphore_wait(sema, DISPATCH_TIME_FOREVER);
        [self doWork:i];
        dispatch_semaphore_signal(sema);
    });
}也可以用信号量将异步操作转为同步等待——但不要在主线程这么干,会卡 UI。
dispatch_apply
并发执行固定次数的迭代,阻塞当前线程直到全部完成——相当于并发版 for 循环。适合大量独立的计算密集型任务。
dispatch_apply(100, dispatch_get_global_queue(QOS_CLASS_DEFAULT, 0), ^(size_t i) {
    // 这 100 次迭代可能并发执行
});
需要串行的话直接写 for,不要用 dispatch_apply 指定串行队列——内部仍会并发调度到系统线程。
dispatch_set_target_queue
两个用途:修改优先级、构建队列层级。
修改优先级:将自定义队列绑定到某个全局 QoS 队列。
dispatch_queue_t queue = dispatch_queue_create("com.example.queue", NULL);
dispatch_set_target_queue(queue, dispatch_get_global_queue(QOS_CLASS_BACKGROUND, 0));队列层级:将多个队列的目标设为同一个串行队列,这些队列的任务会在该串行队列上排队执行。
dispatch_queue_t target = dispatch_queue_create("target", DISPATCH_QUEUE_SERIAL);
dispatch_set_target_queue(queueA, target);
dispatch_set_target_queue(queueB, target);
// queueA 和 queueB 的所有任务都在 target 上串行执行
dispatch_source
dispatch_source 用于监控系统级事件,在事件发生时异步回调。常见类型:
| source 类型 | 用途 |
|---|---|
DISPATCH_SOURCE_TYPE_TIMER |
定时器 |
DISPATCH_SOURCE_TYPE_DATA_ADD / OR |
自定义事件合并 |
DISPATCH_SOURCE_TYPE_READ / WRITE |
文件描述符读写就绪 |
DISPATCH_SOURCE_TYPE_SIGNAL |
Unix 信号监控 |
DISPATCH_SOURCE_TYPE_MEMORYPRESSURE |
内存压力通知 |
dispatch_source_timer —— GCD 的定时器,与 NSTimer 的关键区别:不需要 RunLoop,可以在任意后台线程使用,不受主线程 RunLoop 模式影响。
dispatch_source_t timer = dispatch_source_create(DISPATCH_SOURCE_TYPE_TIMER, 0, 0,
                                                  dispatch_get_main_queue());
// 起始时间 + 间隔(纳秒)+ 容差
dispatch_source_set_timer(timer,
    DISPATCH_TIME_NOW,
    1 * NSEC_PER_SEC,
    0.1 * NSEC_PER_SEC);  // 容差:允许系统延迟以节省能耗

dispatch_source_set_event_handler(timer, ^{
    NSLog(@"每秒触发一次");
});

dispatch_source_set_cancel_handler(timer, ^{
    // 清理资源
});

dispatch_resume(timer);  // source 创建后默认为暂停,需手动启动
需要注意:source 的 event handler 与 cancel handler 都会在指定的目标队列上执行。timer 销毁前调用 dispatch_source_cancel + dispatch_resume 确保 cancel handler 被调用,避免资源泄漏。
dispatch_source_data —— 用于线程间自定义事件的合并通知。多次 dispatch_source_merge_data 在 handler 处理前会自动合并为一次回调。
dispatch_source_t source = dispatch_source_create(DISPATCH_SOURCE_TYPE_DATA_ADD, 0, 0,
                                                   dispatch_get_main_queue());
dispatch_source_set_event_handler(source, ^{
    unsigned long total = dispatch_source_get_data(source);
    // 处理累计值
});
dispatch_resume(source);

// 其他线程随时触发
dispatch_source_merge_data(source, 1);
dispatch_source_merge_data(source, 5);  // handler 收到 total = 6
dispatch_suspend / dispatch_resume
GCD 队列和 dispatch_source 创建后都是可运行状态,但 source 创建后默认为暂停。暂停与恢复的操作必须成对——每次 dispatch_suspend 都需要一个对应的 dispatch_resume 才能恢复执行。
dispatch_suspend(queue);   // 暂停队列:已提交的任务暂停调度,已在执行的继续跑完
dispatch_resume(queue);    // 恢复调度
注意:
dispatch_suspend/dispatch_resume的计数必须平衡。你无法查询当前挂起次数,只能靠代码逻辑保证配对。- 主队列 suspend 的陷阱:suspend 后,如果把
dispatch_resume通过 async block 提交回主队列,这个 resume 永远不会被执行——被挂起的队列不会调度新任务。因此主队列 suspend 后,要么在同一个调用栈里同步 resume(不经过队列排队),要么在其他线程调用 resume。最安全的做法是绝不在主队列上调用dispatch_suspend——如果确实需要,把 suspend 和 resume 都放在同一个方法里立即完成,不要留时间窗口。 - dispatch_source 创建后必须
dispatch_resume一次才能启动(初始挂起计数为 1)。dispatch_source_cancel后如果挂起计数 > 0,需要再 resume 一次让 cancel handler 执行。
底层原理
在写之前并不知道GCD的原理不考
但是既然都整理出来了
那还是发上去吧
前面讲的都是“怎么用”。这一节讲“凭什么”——为什么串行队列能串行、为什么 dispatch_sync 会死锁、为什么线程会爆炸。
libdispatch:GCD 的真身
GCD 不是 Foundation 的一部分,也不在 objc runtime 里。它的实现是一个独立的开源库 libdispatch,源码可以在两个地方看到:
opensource.apple.com/source/libdispatch/—— Apple 官方 dropgithub.com/apple/swift-corelibs-libdispatch—— 跨平台版,同源且更新更勤
下面提到的结构体,dq_state 的位域定义在 src/queue_internal.h,核心逻辑在 src/queue.c 和 src/inline_internal.h。
对象模型:GCD 自己的一套“isa”
libdispatch 实现了一套类 ObjC 的对象系统。所有 GCD 类型(queue、source、group、semaphore)头部布局都相同:
struct dispatch_object_s {
    const struct dispatch_object_vtable_s *do_vtable; // 相当于 isa
    int volatile do_ref_cnt;      // 内部引用计数
    int volatile do_xref_cnt;     // 外部引用计数
    struct dispatch_object_s *volatile do_next;  // 侵入式链表指针
    struct dispatch_queue_s *do_targetq;         // 目标队列
    void *do_ctxt;
    void *do_finalizer;
};
两个细节值得注意:
1. dispatch_object_t 是一个 transparent union,所以 dispatch_queue_t、dispatch_group_t 都能直接传给 dispatch_retain / dispatch_release。
2. 引用计数是双份的。do_ref_cnt 记录内部持有(比如队列里还有未执行的任务、还挂在别的队列上),do_xref_cnt 记录你的代码持有。只有外部计数归零、且内部计数也归零,对象才会真正析构。这就是为什么“队列还没跑完任务时释放它,任务照样会执行完”。
iOS 6 起开启了 OS_OBJECT_USE_OBJC,do_vtable 就是真正的 isa,GCD 对象成了货真价实的 ObjC 对象(类名形如 OS_dispatch_queue),因此能被 ARC 管理、能放进 NSArray。这也是为什么 iOS 6 之后不再需要手动 dispatch_release。
队列不是线程:target queue 链
这是最重要、也最反直觉的一点:
你创建的队列不拥有任何线程。它只是一个“任务容器 + 并发语义”。
每个队列都有一个 do_targetq 指针指向它的目标队列。任务并不在你的队列上执行,而是沿着这条链一路向上冒泡,最终到达 root queue(根队列),由根队列去向系统要线程。
你的串行队列 ──► 某个 root queue ──► pthread workqueue ──► 内核线程池root queue 是 libdispatch 里的一组全局静态队列 _dispatch_root_queues[],按 QoS 等级 × 是否 overcommit 组合,一共十来个。
这解释了几个常见困惑:
| 困惑 | 答案 |
|---|---|
dispatch_get_global_queue 返回的是“四条并发队列”吗? |
不是。它们是线程池的入口标签,按 QoS 分组,本身不持有线程 |
| 串行队列会绑定一条固定线程吗? | 不会(主队列除外)。连续两个 block 完全可能跑在不同线程上,GCD 只保证它们不重叠 |
dispatch_set_target_queue 为什么能改优先级? |
因为它改的就是这条冒泡链的终点,换一个 QoS 的 root queue |
前面讲 dispatch_set_target_queue 时说“多个队列指向同一个串行队列就会互相串行”——现在原因清楚了:它们的任务最终都要挤进同一个串行的目标队列排队。
dq_state:GCD 最精妙的设计
现代 libdispatch 把队列的几乎全部状态压进一个 64 位原子整数 dq_state,所有操作都是对它做 CAS(Compare-And-Swap),基本不用传统的锁。
| 位域 | 含义 |
|---|---|
dq_state_lock(低 32 位) |
drain lock,存放当前正在“排干”该队列的线程 tid |
DISPATCH_QUEUE_WIDTH |
剩余并发额度。串行队列 width = 1,并发队列 = DISPATCH_QUEUE_WIDTH_FULL(0xfff) |
DISPATCH_QUEUE_IN_BARRIER |
当前正在执行 barrier 任务 |
DISPATCH_QUEUE_ENQUEUED |
该队列自身已经被塞进上级队列 |
DISPATCH_QUEUE_DIRTY |
有新任务入队,drain 循环需要重新检查 |
max_qos |
当前被 override 到的最高 QoS |
串行队列的“串行”不是靠锁住某条线程,而是靠 width = 1 这个额度。 谁 CAS 抢到 drain lock,谁就负责把队列里的任务一个个取出来执行,其他线程尝试失败后直接返回去干别的。
并发队列则相反:width 很大,多个线程可以同时抢到额度并行 drain。
barrier 的实现也一目了然了:barrier 任务要求把 width 全部占满(DISPATCH_QUEUE_WIDTH_FULL),所以它必须等所有正在执行的任务释放额度,且执行期间没有额度留给别人。这也解释了为什么 barrier 在全局队列上无效——全局 root queue 是系统共享的,libdispatch 不允许你把整个系统线程池独占,于是直接降级成普通 async。
任务的载体:dispatch_continuation
dispatch_async(q, ^{...}) 并不是把 block 直接存进队列,而是包装成一个 continuation:
struct dispatch_continuation_s {
    union { const void *do_vtable; uintptr_t dc_flags; };
    union { pthread_priority_t dc_priority; int dc_cache_cnt; ... };
    dispatch_function_t dc_func;   // 要调用的函数
    void *dc_ctxt;                 // Block_copy 之后的 block
    voucher_t dc_voucher;          // 携带 QoS / activity trace 上下文
    ...
};
注意它的头部布局和 dispatch_object_s 兼容,所以 continuation 和队列本身能混在同一条链表里——“队列作为任务被塞进上级队列”正是靠这个实现的。
这里有个关键的性能优化:continuation 有 per-thread 缓存。每条线程的 TLS 上挂着一条空闲 continuation 链表,高频 dispatch_async 基本不触发 malloc。这是 GCD 比 NSOperationQueue 快一个数量级的主要原因之一——后者每次都要创建一个真正的 ObjC 对象。
顺带回答一个常见面试题:dispatch_async 的 block 为什么必须被 copy? 因为 block 字面量默认在栈上,dispatch_async 立即返回后当前函数栈帧就销毁了。libdispatch 在打包 continuation 时会执行 Block_copy 把它挪到堆上,并在执行完后 Block_release。这也是为什么 block 里强引用 self 会造成 self 的生命周期被延长到任务执行完。
入队:无锁的 MPSC 队列
队列体本身是一条 MPSC(多生产者、单消费者)侵入式链表,靠 dq_items_head / dq_items_tail 两个指针维护。入队的核心代码简化后是这样:
// 一条原子交换指令就占好了位置
prev = os_atomic_xchg(&dq->dq_items_tail, dc, release);
if (likely(prev)) {
    os_atomic_store(&prev->do_next, dc, relaxed);   // 接到前一个节点后面
} else {
    dq->dq_items_head = dc;
    _dispatch_queue_wakeup(dq, qos, ...);           // 只有从空变非空才需要唤醒
}
两个要点:
- 入队是 wait-free 的,只需一条
xchg指令,不需要任何锁。这是 GCD 高吞吐的基础。 - 只有队列从“空”变成“非空”时才触发 wakeup。已经在跑的队列不需要额外通知,drain 循环自己会发现新任务(靠
DIRTY位)。
wakeup 会把队列自身标记为 ENQUEUED,然后推给它的 do_targetq,递归向上直到 root queue。只有 root queue 才会真正去申请线程。
dispatch_async 的完整旅程
把前面几节串起来:
dispatch_async(queue, block)
  ↓
① 从 TLS 缓存取一个 continuation,Block_copy 存进 dc_ctxt
  ↓
② 一条 xchg 原子指令挂到 queue 的 MPSC 链表尾部
  ↓
③ 若队列原本为空 → wakeup,CAS 设置 ENQUEUED 位
  ↓
④ 沿 do_targetq 链向上冒泡,直到某个 root queue
  ↓
⑤ root queue 调 _pthread_workqueue_addthreads() 向内核要线程
  ↓
⑥ 内核唤醒/新建一条线程,从 _dispatch_worker_thread2 回到用户态
  ↓
⑦ 线程 CAS 抢 drain lock,循环取出 continuation 并执行 dc_func
dispatch_sync 为什么不开线程
dispatch_sync 走的是完全不同的一条路。它压根不走上面那条链表:
dispatch_sync(queue, block)
  ↓
① CAS 尝试直接抢占 queue 的 drain lock
  ↓
② 抢到了 → 就在【当前线程】上直接调用 block,然后释放 lock
抢不到 → 挂一个等待节点,当前线程睡眠,等待被移交这就是“dispatch_sync 不会开启新线程”的根本原因——它是一次“借用当前线程去代跑目标队列的任务”,本质上更接近加锁,而不是调度。
副作用是:dispatch_sync 里的 block 能看到调用者的栈上下文,crash 时回溯栈是连续的,这在调试时非常有用。
现在可以给死锁一个精确的解释了。 前面讲过现象——“当前任务等新任务,新任务等当前任务”,源码层面是这样:
dispatch_sync 在 CAS 之前,会先把 dq_state 低 32 位里的 owner tid 和 _dispatch_tid_self() 做比较。如果相等,说明当前线程已经持有这个队列的 drain lock,又要求获取它——这是一个必然无法满足的请求,libdispatch 直接主动崩溃:
BUG IN CLIENT OF LIBDISPATCH: dispatch_sync called on queue
already owned by current thread
所以严格来说,串行队列 sync 自己不是“卡死”而是“被 libdispatch 主动 crash”——它检测得出来,就不让你死等。而前面场景三那种 A 等 B、B 等 A 的跨队列死锁,libdispatch 无法检测(那是两个不同的 owner),才会真正永久卡住。这是两类死锁的本质差别,面试时能区分开是加分项。
另外,dispatch_sync 抢不到锁时不是傻等:libdispatch 会通过 turnstile 机制,把等待者的 QoS 推给当前持有锁的线程,防止高优先级线程被低优先级线程拖死(优先级反转,下一章会详细讲)。任务执行完后还会做 ownership transfer——直接把 drain 权移交给等待线程,而不是让它醒来重新竞争。
线程池与线程爆炸
root queue 的 wakeup 最终调用 _pthread_workqueue_addthreads(),这是用户态与内核的分界线。往下就是 XNU 内核的 pthread_workqueue 子系统在管理线程池。
线程爆炸的机理,这是面试高频题:
内核只能看到“这条线程是不是 runnable”,它无法知道你的线程是在干活还是在傻等。一旦你的 block 里执行了:
sleep/usleep- 等一把锁或信号量
- 同步的网络请求、文件 IO
内核就认为这条线程“不可用”了,为了维持目标并发度,它会再补一条新线程。你的代码继续提交任务、继续阻塞,内核继续补线程……几十条线程转眼就起来了,每条 512KB~1MB 栈内存,然后 crash。
这也解释了另一个细节:dispatch_queue_create 创建的队列,默认 target 到 overcommit 类型的 root queue。overcommit 意味着“允许超过 CPU 核数创建线程”,目的是保证你的串行队列不会因为线程池被占满而永远得不到执行。代价就是它更容易参与线程爆炸。
结论:GCD 的第一信条是 don't block the pool。 需要限流请用 dispatch_semaphore 或 NSOperationQueue.maxConcurrentOperationCount,而不是靠猛开队列。
GCD 到底能开多少条线程
这是个高频面试题,但网上流传的答案需要加限定条件才准确。
流传最广的说法是:
- 所有并发队列(含全局队列)加起来最多创建 64 条线程;
- 整个进程最多 512 条线程;
- 加上主线程等系统线程,约 516 条。
这套数字来源于早期 libdispatch 的实现——那时 dispatch_queue_create 出来的并发队列,其目标队列只能是 LOW / DEFAULT / HIGH / BACKGROUND 这四个不支持 overcommit 的全局队列,而内核对非 overcommit 的 workqueue 线程数做了 64 的硬上限。
但这个数字在现代系统上已经不能当成事实。 当前的 libdispatch 和 XNU 内核里,线程池上限是由内核动态决定的,受这些因素影响:
- 设备的 CPU 核心数;
- 当前系统的整体内存压力和负载;
- 队列的 QoS 等级(不同 QoS bucket 有各自的配额);
- 是否 overcommit(overcommit 队列不受常规上限约束)。
面试时的稳妥答法:先说结论“早期实现里非 overcommit 的并发队列上限是 64 条,进程级上限 512 条”,再补一句“现代 libdispatch 已改为由内核根据核心数和系统负载动态调整,没有固定的魔法数字,但上限总是存在,所以不能依赖无限开线程”。这样既答到了考点,又不会在被追问“你确定现在还是 64 吗”时翻车。
比数字更重要的是为什么串行队列不受这个限制拖累:dispatch_queue_create 创建的串行队列默认 target 到支持 overcommit 的全局队列。overcommit 的语义是“有任务提交就允许新开线程,不管当前线程数是否已达常规上限”,这样才能保证你的串行队列不会因为线程池被并发任务占满而饿死。代价就是——滥用串行队列同样会造成线程爆炸,这一点和上一节是同一回事。
应该开多少条线程
上一个问题是“系统允许你开多少”,这个问题是“你应该开多少”。答案取决于任务的性质。
CPU 密集型任务(图像处理、加解密、大量计算、复杂布局计算):
任务几乎全程占用 CPU,没有等待。这时线程数超过核心数没有任何意义——多出来的线程只会互相抢时间片,白白增加上下文切换开销。
最佳线程数 ≈ CPU 核心数
I/O 密集型任务(网络请求、文件读写、数据库操作):
任务大部分时间在等待 I/O 完成,此时线程并不占用 CPU。如果线程数只等于核心数,CPU 会在等待期间大量闲置。适当多开线程可以让 CPU 在某些线程等待时去执行另一些线程。
最佳线程数 ≈ CPU 核心数 × 2(经验值)
更精确的理论公式是:
最佳线程数 = 核心数 × (1 + 等待时间 / 计算时间)I/O 密集型任务的等待时间约等于计算时间时,代入即得 2 倍核心数。等待占比越高,可以开的线程越多。
获取核心数:
NSUInteger cores = [NSProcessInfo processInfo].activeProcessorCount;实际工程中的建议:不要自己算完再手动开线程。用 NSOperationQueue.maxConcurrentOperationCount 或信号量做限流,把具体调度交给 GCD——它比你更清楚当前系统的负载。这两个公式的价值在于给你一个合理的数量级(是 4 还是 40),而不是精确值。
dispatch_once 的实现
面试常问“dispatch_once 凭什么线程安全,为什么快”。现在的实现把 dispatch_once_t(本质是 long)复用成了一个 lock word:
// 快路径(绝大多数调用走这里)
if (likely(os_atomic_load(val, acquire) == DLOCK_ONCE_DONE)) {
    return;   // 一条 load 指令,没有任何原子读改写、没有锁
}
// 慢路径
_dispatch_once_callout(...);  // CAS 写入自己的 tid 当锁 → 执行 block
                              // → 置 DLOCK_ONCE_DONE(release 语义)
三个考点:
- 快路径零开销:只有一次 acquire load,配合
__builtin_expect分支预测,性能几乎等同于直接读一个全局变量。 - acquire / release 内存序:写入方用 release 保证“block 内部的初始化写操作”一定先于“标志位写入”对其他线程可见;读取方用 acquire 保证读到标志位后,一定能看到完整初始化好的对象。这是防止“拿到一个半初始化单例”的关键——也正是手写双重检查锁最容易写错的地方。
- 慢路径有优先级继承:后到的线程不是自旋,而是走内核 ulock 睡眠,同时把 QoS 推给正在执行 block 的线程。
顺带说明为什么 dispatch_once_t 必须是 static 或全局变量:它需要在整个进程生命周期内保持同一份状态。写成局部变量的话每次调用都是全新的 0,block 每次都会执行。
dispatch_semaphore 的实现
信号量的核心是一个 long dsema_value 加一个 Mach 内核信号量:
// signal:先原子加,大于 0 直接返回,完全不进内核
long value = os_atomic_inc2o(dsema, dsema_value, release);
if (likely(value > 0)) return 0;
// 否则才 semaphore_signal() 唤醒等待者

// wait:先原子减,大于等于 0 直接返回,完全不进内核
long value = os_atomic_dec2o(dsema, dsema_value, acquire);
if (likely(value >= 0)) return 0;
// 否则才 semaphore_wait() 陷入内核睡眠
无竞争时,信号量就是两条原子指令,一次内核调用都没有。 只有真正需要阻塞时才会陷入内核。这就是它比 NSLock 快的原因。
dispatch_group 在现代实现中是独立结构(早期是 semaphore 的包装):dg_state 高位存计数,enter / leave 就是对它做原子加减,归零时唤醒所有 waiter 并把 notify 的 continuation 投递出去。leave 多调一次会 crash,因为它检测到了计数下溢。
主队列与 RunLoop
主队列是唯一 thread-bound(绑定线程) 的队列,它的 drain 由两条路径之一驱动:
dispatch_main()—— 纯命令行 GCD 程序使用;- CFRunLoop 集成 —— App 中的实际情况。主 RunLoop 注册了主队列的一个 mach port,
__CFRunLoopServiceMachPort收到消息后会调用一个名字很长很长的函数:
__CFRUNLOOP_IS_SERVICING_THE_MAIN_DISPATCH_QUEUE__这个符号在卡顿分析和崩溃日志里非常常见,看到它就说明当前栈正在执行 dispatch_async(dispatch_get_main_queue(), ...) 提交的 block。
这也解释了两件事:
- 主队列的 block 只会在 RunLoop 的特定阶段执行,所以它的执行时机不像后台队列那样“立刻”;
- 主线程正忙于一个长任务时,
dispatch_async(main)的 block 会被延后到当前任务结束、RunLoop 走到对应阶段才执行。
一个表格
| 现象 | 底层原因 |
|---|---|
| 串行队列不绑定固定线程 | 队列只是容器,线程由 root queue 向内核 workqueue 申请 |
dispatch_sync 不开新线程 |
它抢 drain lock 后在当前线程直接执行 block |
| 串行队列 sync 自己会崩溃 | dq_state 里 owner tid 与当前线程 tid 相同,libdispatch 主动 fatal |
| barrier 在全局队列上无效 | barrier 需独占 width,系统不允许独占共享线程池 |
| 阻塞导致线程爆炸 | 内核区分不出“在干活”和“在等待”,会补充新线程维持并发度 |
dispatch_once 极快 |
快路径只有一条 acquire load |
| 信号量无竞争时很快 | 无竞争路径纯原子操作,不进内核 |
| 主队列 block 时机不确定 | 由主 RunLoop 驱动,需等到对应阶段 |
面试题
从bilibili上的课,以及一些奇奇怪怪的东西上整理了一些可能会问的问题
所有的参考资料都会在最后给出
Q1:GCD 的队列和线程是什么关系?
答:没有一一对应关系。队列只是任务的容器,本身不持有线程。任务沿着 target queue 链向上冒泡到 root queue,由 root queue 向内核的 pthread_workqueue 申请线程。
推论:
- 串行队列不绑定固定线程,前后两个任务可能在不同线程执行,GCD 只保证不重叠;
dispatch_get_global_queue返回的不是“四条队列”,而是按 QoS 分组的线程池入口;- 主队列是唯一绑定线程的队列(绑定主线程)。
Q2:同步/异步 × 串行/并发,四种组合分别开几条线程?
| 组合 | 是否开新线程 | 执行方式 |
|---|---|---|
| 同步 + 串行 | 不开 | 当前线程顺序执行 |
| 同步 + 并发 | 不开 | 当前线程顺序执行 |
| 异步 + 串行 | 开 1 条 | 新线程上顺序执行 |
| 异步 + 并发 | 开多条 | 多线程并发执行 |
记忆要点:只有 async 才可能开线程,sync 永远不开。
补充陷阱:async 到主队列不会开线程,因为主队列绑定主线程。
Q3:下面这段代码输出什么?
NSLog(@"1");
dispatch_queue_t queue = dispatch_queue_create("q", DISPATCH_QUEUE_SERIAL);
dispatch_async(queue, ^{
    NSLog(@"2");
    dispatch_sync(queue, ^{
        NSLog(@"3");
    });
    NSLog(@"4");
});
NSLog(@"5");答:输出 1、5、2(5 和 2 顺序不定),然后崩溃,3 和 4 永远不会执行。
这题的加分点在于:不要只说“死锁”。串行队列 sync 自己时,libdispatch 会检测到 dq_state 中的 owner tid 就是当前线程,直接主动 crash 并报 BUG IN CLIENT OF LIBDISPATCH,而不是无限等待。真正的“卡死”发生在跨队列互等的场景(A 等 B、B 等 A),那种 libdispatch 检测不出来。
Q4:经典的 `performSelector` + 死锁变体
dispatch_async(dispatch_get_global_queue(0, 0), ^{
    NSLog(@"1");
    [self performSelector:@selector(printTwo) withObject:nil afterDelay:0];
    NSLog(@"3");
});答:只输出 1 和 3,printTwo 不执行。
performSelector:withObject:afterDelay: 依赖 RunLoop 的 timer
而 GCD 从线程池取到的线程默认没有开启 RunLoop
同理,NSTimer 在后台 GCD 线程上也不会触发——这正是应该用 dispatch_source_t timer 的场景,它不依赖 RunLoop
Q5:`dispatch_async` 里的 block 为什么会被 copy?
栈上的 block 在 dispatch_async 返回后就随栈帧销毁了。
libdispatch 打包 continuation 时会 Block_copy 把它挪到堆上,
执行完再 Block_release
延伸:这意味着 block 捕获的 self 会被 retain 到任务执行完。如果 block 里又持有了自己(例如 dispatch_source 的 handler 强引用 self,self 又持有 source),就会形成循环引用。
Q6:什么是线程爆炸?怎么避免?
内核的 workqueue 无法区分“线程在计算”和“线程在阻塞等待”。一旦任务里做了 sleep、等锁、同步 IO,内核认为该线程不可用,会补充新线程来维持并发度。持续提交阻塞任务就会导致线程数失控,每条线程 512KB~1MB 栈内存,最终 OOM 崩溃。
避免方式:
- 不要在 GCD 任务里做阻塞操作,用异步 API;
- 需要限流用
dispatch_semaphore控制并发数,而不是猛开队列; - 大量同类任务用
dispatch_apply,它内部会按 CPU 核数控制并发; - 用少量长期存在的串行队列,而不是频繁创建队列。
Q7:`dispatch_once` 为什么线程安全,为什么快?
快路径只有一次 acquire 语义的原子 load,判断标志位是否为 DLOCK_ONCE_DONE,命中直接返回,没有任何原子读改写和锁开销。慢路径通过 CAS 写入线程 tid 充当锁,后到的线程走内核 ulock 睡眠并做优先级继承。
关键在内存序:写入方 release、读取方 acquire,保证不会读到“标志位已置位但对象只初始化了一半”的中间状态。手写双重检查锁最常见的 bug 就是漏了这个屏障。
Q8:`dispatch_barrier` 的原理是什么?为什么在全局队列上无效?
dq_state 中有一个 width 字段表示剩余并发额度。barrier 任务要求占满全部 width,因此它必须等所有在执行的任务释放额度,执行期间也没有额度留给别人,从而实现独占。
全局 root queue 是整个系统共享的,libdispatch 不允许单个 App 独占系统线程池,所以在全局队列上 dispatch_barrier_async 会降级为普通 dispatch_async。必须用自己 dispatch_queue_create 出来的并发队列。
Q9:如何用 GCD 实现多读单写?
@interface DataStore ()
@property (nonatomic, strong) dispatch_queue_t queue;
@property (nonatomic, strong) NSMutableDictionary *dict;
@end

@implementation DataStore

- (instancetype)init {
    if (self = [super init]) {
        _queue = dispatch_queue_create("com.example.rw", DISPATCH_QUEUE_CONCURRENT);
        _dict = [NSMutableDictionary dictionary];
    }
    return self;
}

// 读:并发,用 sync 以便返回结果
- (id)objectForKey:(NSString *)key {
    __block id result = nil;
    dispatch_sync(self.queue, ^{
        result = self.dict[key];
    });
    return result;
}

// 写:barrier 独占,用 async 不阻塞调用方
- (void)setObject:(id)obj forKey:(NSString *)key {
    dispatch_barrier_async(self.queue, ^{
        self.dict[key] = obj;
    });
}

@end要点:读用 sync(需要返回值)、写用 barrier_async(不需要等待),队列必须是自建的并发队列。
Q10:`atomic` 能保证线程安全吗?
不能
在之前讲过atomic 只保证单次 getter / setter 调用本身不被拆开,即你不会读到一个“写了一半”的指针值。但它保护不了复合操作:
// 即使 count 是 atomic 的,这段代码依然不安全
self.count = self.count + 1; // 读 → 加 → 写,三步之间可能被其他线程插入同理,@property (atomic, strong) NSMutableArray *array; 保护的是 array 这个指针的读写,而 [self.array addObject:] 修改的是数组内容,完全不受保护。
真正的线程安全需要你保证整段相关操作的原子性——用锁、串行队列或 barrier。
Q11:GCD 和 NSOperationQueue 怎么选?
| 维度 | GCD | NSOperationQueue |
|---|---|---|
| 层级 | C 接口,底层 | ObjC 对象,基于 GCD 封装 |
| 性能 | 更高(continuation 有 TLS 缓存,不创建对象) | 略低(每个 operation 是真实对象) |
| 依赖关系 | 不支持,需手动用 group / 串行队列模拟 | 原生支持 addDependency: |
| 取消 | 不支持(提交后无法撤销) | 支持 cancel / cancelAllOperations |
| 最大并发数 | 不能直接设置,需用信号量模拟 | maxConcurrentOperationCount 一行搞定 |
| 状态监控 | 无 | KVO 监听 isExecuting / isFinished |
| 暂停恢复 | dispatch_suspend / resume |
suspended 属性 |
选型原则:简单的异步执行、一次性任务用 GCD;需要依赖、取消、并发数控制、进度监控(典型如下载管理器)用 NSOperationQueue。
Q12:`dispatch_group` 的 `enter` / `leave` 和 `dispatch_group_async` 有什么区别?
dispatch_group_async 适用于同步任务——block 执行完就算完成。
但如果 block 内部又是一个异步操作(比如网络请求),block 会立刻返回,group 会误以为任务已完成。这时必须手动配对:
dispatch_group_enter(group);
[self fetchDataWithCompletion:^(id data) {
    // 处理数据
    dispatch_group_leave(group);   // 在真正的完成回调里 leave
}];陷阱:leave 少调一次,notify 永远不触发;多调一次,计数下溢直接 crash。有多个 return 分支时要确保每条路径都 leave。
Q13:GCD 最多能开多少条线程?
流传最广的说法是:并发队列合计最多 64 条,进程级上限 512 条。这套数字来自早期实现——那时自定义并发队列只能 target 到四个不支持 overcommit 的全局队列,内核对其线程数有 64 的硬上限。
但要加限定条件:现代 libdispatch 已改为由内核根据 CPU 核心数、系统负载、QoS 等级动态决定,没有固定的魔法数字。
稳妥的答法是先给出这两个经典数字并说明出处,再补充“当前实现是动态调整的,但上限总是存在”。
关键在于理解 overcommit:dispatch_queue_create 创建的串行队列默认 target 到支持 overcommit 的全局队列,意味着有任务提交就允许新开线程、不受常规上限约束——这保证了串行队列不会被并发任务饿死,但也意味着滥用串行队列同样会线程爆炸。
Q14:项目中应该开多少条线程?
取决于任务性质:
| 任务类型 | 特征 | 建议线程数 |
|---|---|---|
| CPU 密集型(图像处理、加解密、大量计算) | 全程占用 CPU,几乎不等待 | ≈ CPU 核心数 |
| I/O 密集型(网络、文件、数据库) | 大部分时间在等待,不占 CPU | ≈ 核心数 × 2 |
CPU 密集型超过核心数没有意义——多出的线程只会互相抢时间片,徒增上下文切换开销。I/O 密集型则要多开,否则 CPU 在等待期间大量闲置。
理论公式:最佳线程数 = 核心数 × (1 + 等待时间 / 计算时间)。等待时间约等于计算时间时即为 2 倍核心数。
核心数用 [NSProcessInfo processInfo].activeProcessorCount 获取。
加分补充:实际工程中不要手动开线程,而是用 maxConcurrentOperationCount 或信号量限流,把调度交给 GCD。公式的价值是给出合理的数量级,不是精确值。
Q15:如何实现多个异步任务全部完成后再统一处理?
共四种方法:
1. dispatch_group(最常用、最推荐)
dispatch_group_t group = dispatch_group_create();
for (NSURL *url in urls) {
    dispatch_group_enter(group);
    [self downloadURL:url completion:^{
        dispatch_group_leave(group);
    }];
}
dispatch_group_notify(group, dispatch_get_main_queue(), ^{
    NSLog(@"全部完成");
});
任务是异步的必须用 enter / leave;任务是同步的可以直接用 dispatch_group_async。
2. dispatch_barrier_async
把所有任务提交到自定义并发队列,最后提交一个 barrier 任务。barrier 会等前面所有任务完成后才执行。注意必须是自建并发队列。
3. dispatch_semaphore
信号量初值设为 0,每个任务完成后 signal,等待方连续 wait N 次。或初值设为任务数的负数配合计数。缺点是需要一条线程阻塞等待,不如前两种优雅。
4. NSOperationQueue + 依赖
把最终处理封装成一个 operation,用 addDependency: 让它依赖所有下载 operation。也可以用队列的 addBarrierBlock:(iOS 13+)或 waitUntilAllOperationsAreFinished(会阻塞当前线程,慎用)。
选型:日常首选 dispatch_group;如果任务本身还要做读写互斥就用 barrier;需要取消和依赖管理用 NSOperation。
Q16:GCD 怎么实现 NSOperationQueue 那样的任务依赖?
有三种做法:
1. 调度组:把前置任务放进 group,用 dispatch_group_notify 触发后续任务。
2. 信号量:初值设为 0,后一个任务开始前 wait,前一个任务结束时 signal。
3. 串行队列:最简单——把有先后关系的任务依次提交到同一条串行队列,天然按顺序执行。
追问:如果任务数量很多、依赖关系复杂怎么办?
这时候手写 group 嵌套会失控,本质上应该用拓扑排序:
- 把任务抽象成有向图的节点,依赖关系抽象成有向边(A → B 表示 B 依赖 A);
- 统计每个节点的入度(有多少个任务依赖它先完成);
- 把所有入度为 0 的任务(不依赖任何人)放入队列并发执行;
- 每当一个任务完成,把它指向的所有后继节点的入度减 1;
- 减到 0 的节点说明依赖已全部满足,立即投入执行;
- 重复直到所有任务完成。
如果最后还有节点入度不为 0,说明图中存在环,即循环依赖,必须报错——这也正是 NSOperation 官方文档警告“不要创建循环依赖,会导致死锁”的原因。
实际工程建议:依赖关系复杂时直接用 NSOperationQueue,它内部已经实现了这套逻辑(通过 KVO 监听 isFinished 驱动),没必要自己造轮子。能讲清楚拓扑排序,是为了说明“你知道 NSOperation 底层在做什么”。
Q17:iOS 中线程间通信有哪些方式?
| 方式 | 说明 | 典型场景 |
|---|---|---|
| GCD | dispatch_async / dispatch_sync 在队列间切换 |
最常用:后台计算完回主线程更新 UI |
performSelector:onThread: |
在指定线程执行方法,依赖该线程的 RunLoop | 与常驻线程通信 |
| NSOperation 依赖 / 完成回调 | 通过依赖关系或 completionBlock 传递 |
任务链 |
| NSNotification | 通知中心广播,在哪个线程发就在哪个线程收 | 松耦合的跨模块通知 |
| NSMachPort / NSPort | 底层 mach 消息,RunLoop 的 Source1 | 极少直接用 |
两个高频追问点:
- 通知是同步的——
postNotification会在当前线程同步调用所有观察者,发完才返回。所以在子线程发通知,观察者的回调也在子线程,如果里面更新 UI 会出问题,必须自己切回主线程。 performSelector:onThread:要求目标线程的 RunLoop 处于运行状态,否则消息永远不会被处理。这也是“线程保活”的核心原理。
Q18:信号量的 `wait` 和 `signal` 次数不匹配会怎样?
wait 多于 signal:信号量计数变为负数,多出来的等待方永久阻塞。最常见的成因是任务中途抛异常、提前 return 或崩溃,导致 signal 没被执行。防御写法是把 signal 放进 @finally 或用 defer 语义保证一定执行。
signal 多于 wait:不会死锁,但计数会超过初始值,等于并发上限失控——初值 3 的信号量多 signal 两次后,可能同时跑 5 个任务,限流形同虚设。
另外一个独立的坑:信号量销毁时如果当前值小于初始值(说明还有线程在等待),会直接 crash。
还要注意 wait 是阻塞式等待。如果在 GCD 线程池的线程上大量使用信号量等待,这些线程会处于“被占用却闲置”的状态无法复用,内核又会补充新线程——这正是上面讲过的线程爆炸的一种典型诱因。
Q19(进阶):`dispatch_sync` 一定不开线程,那它是怎么“插队”的?
它不是插队,而是借用当前线程。dispatch_sync 会 CAS 尝试直接抢占目标队列的 drain lock,抢到就在调用线程上直接执行 block。所以它的语义更接近“加锁 + 执行”,而非“调度任务”。
这也带来两个可观察的现象:block 里能看到调用者的栈上下文;crash 回溯栈是连续的,不会断在 dispatch_async 处。
抢不到锁时,libdispatch 会通过 turnstile 把等待者的 QoS 推给持有者,避免优先级反转;执行完成后直接把 drain 权移交给等待线程,省掉一次重新竞争。
锁的底层原理
前面在“线程同步”一章介绍了 Foundation 提供的各种锁的用法,这一章讲它们的实现。这部分是 iOS 面试中和 GCD 并列的高频考点,而且深度往往更深——因为 @synchronized 的实现就在 objc4 开源代码里,面试官可以一直往下问。
一切锁的起点:原子操作
所有锁的最底层,都是同一个东西:CPU 提供的原子指令。
考虑最朴素的“加锁”逻辑:
if (lock == 0) {   // ① 检查锁是否空闲
    lock = 1;      // ② 占用它
}
这段代码在多线程下是错的。两条线程可能同时执行完 ①(都看到 0),然后都执行 ②,于是两条线程同时认为自己拿到了锁。问题在于“检查”和“设置”之间存在时间窗口。
硬件的解决方案是提供一条不可分割的指令,把检查和设置合并成一个不可打断的操作:
| 原语 | 语义 |
|---|---|
| CAS(Compare-And-Swap) | “如果内存里的值等于期望值,就把它改成新值”,整个过程原子完成,返回是否成功 |
| XCHG(Exchange) | 原子交换:把新值写入内存,同时返回旧值 |
| Fetch-And-Add | 原子加法,返回旧值。dispatch_semaphore 的计数就靠它 |
在 x86 上这些通过 lock 指令前缀实现,ARM 上则是 LDXR / STXR(独占加载/存储)配对。
记住这一点:锁不是操作系统凭空创造的,它是在 CPU 原子指令之上构建的软件抽象。 所有更复杂的机制——互斥锁、信号量、条件变量——归根结底都是“原子指令 + 线程休眠唤醒策略”的组合。
内存屏障:一个容易被忽略的角色
除了原子性,锁还必须解决可见性和重排序问题。
现代 CPU 和编译器都会为了性能重排指令。如果没有约束,下面这段代码可能出问题:
// 线程 A
obj = createObject();   // ① 构造对象
ready = 1;              // ② 置标志位

// 线程 B
if (ready == 1) {
    use(obj);           // 可能拿到一个尚未构造完的 obj!
}
如果 ① 和 ② 被重排,线程 B 就会看到“标志位已置位但对象还没构造好”。
内存屏障(memory barrier) 用来禁止这种重排。常见的两种语义:
- acquire(获取语义):屏障之后的读写不能被重排到屏障之前。加锁时使用。
- release(释放语义):屏障之前的读写不能被重排到屏障之后。解锁时使用。
这对语义保证了:一个线程在解锁前的所有修改,另一个线程加锁后一定能看见。 这就是锁除了互斥之外的第二个核心作用——很多人只知道前者。
上一章讲的 dispatch_once 用 acquire / release 保证不会读到半初始化的单例,正是这个机制的直接应用。
自旋锁 vs 互斥锁:等待策略的分歧
拿到原子指令后,还有一个关键决策:没抢到锁的线程该干什么?
两种截然不同的策略,构成了锁的两大流派。
自旋锁(Spin Lock):忙等
while (!CAS(&lock, 0, 1)) {
    // 什么也不做,继续试
}线程原地循环重试,不释放 CPU。
- 优点:没有线程切换开销。一旦锁被释放,等待方几乎立刻就能拿到。
- 缺点:等待期间白白烧 CPU。等待时间越长越浪费。
适用场景:临界区极短(几十个 CPU 周期),且是多核系统。因为一次线程上下文切换的代价大约是几微秒,如果临界区比这还短,自旋反而更划算。
互斥锁(Mutex):阻塞等待
if (!CAS(&lock, 0, 1)) {
    syscall(wait);   // 陷入内核,线程进入睡眠,让出 CPU
}
抢不到锁就通过系统调用让线程睡眠,等持有者释放锁时由内核唤醒。
- 优点:等待期间不占 CPU,系统可以调度其他线程。
- 缺点:涉及用户态/内核态切换和线程上下文切换,开销较大(微秒级)。
适用场景:临界区较长,或竞争激烈。
现代实现:两者的混合
实际上现在几乎没有纯粹的自旋锁或纯粹的互斥锁。主流实现都是混合策略:
先自旋一小段时间(假设锁很快会被释放),自旋失败后再陷入内核睡眠。
这样短临界区享受自旋的低延迟,长临界区也不会浪费 CPU。os_unfair_lock 和 pthread_mutex 都是这么做的。
优先级反转
这是并发编程里最容易被忽视、却在面试中几乎必问的问题。它既是 OSSpinLock 被废弃的直接原因,也是现代锁实现里许多设计(记录 owner、turnstile、QoS 传递)存在的理由。所以单独作为一节来讲。
定义:优先级反转(priority inversion)指高优先级线程被低优先级线程间接阻塞,导致实际执行顺序与优先级设定相反的现象。
注意“间接”两个字——这不是简单的“高优先级线程等一把低优先级线程持有的锁”(那叫有界阻塞,是正常且必然的,等待时间不超过临界区长度)。真正的问题在于,等待时间可能变得没有上限。
它有两种形态。
形态一:经典的三线程模型(无界优先级反转)
这是操作系统教材里的标准模型,也是面试最常被要求描述的版本。涉及三条线程:
| 线程 | 优先级 | 行为 |
|---|---|---|
| L | 低 | 持有锁,正在执行临界区 |
| M | 中 | 不需要这把锁,做自己的事 |
| H | 高 | 需要这把锁,被阻塞 |
过程:
- L 先拿到了锁,开始执行临界区;
- H 就绪,抢占 L 开始运行,但发现锁被占用,于是阻塞等待;
- 此时可运行的只剩 L 和 M。M 的优先级高于 L,于是系统调度 M 运行;
- M 不需要这把锁,它可以一直运行下去。而 L 拿不到 CPU,无法执行完临界区,也就无法释放锁;
- 结果是:高优先级的 H 必须等到 M 和 L 都执行完才能继续,实际执行顺序变成了 M → L → H,与优先级完全相反。
之所以叫“无界(unbounded)”反转,是因为 M 这样的中优先级线程可以有很多个、可以运行任意长时间,H 被延迟的时间没有上限。
著名事故:1997 年火星探路者号(Mars Pathfinder)登陆火星后频繁重启,最终定位到的原因正是这个模型——一个低优先级的气象数据线程持有互斥锁,中优先级的通信线程不断抢占 CPU,导致高优先级的总线管理线程超时,触发看门狗重启。NASA 最终通过远程开启优先级继承修复了它。
形态二:自旋锁场景
自旋锁上的优先级反转是上面模型的一个更恶劣的变体——它甚至不需要中优先级线程参与,两条线程就足以致命:
- 低优先级线程 L 拿到了自旋锁,开始执行临界区代码;
- 高优先级线程 H 也要这把锁,于是开始自旋等待;
- 由于 H 优先级更高,系统持续把 CPU 时间片分配给 H;
- L 因为拿不到 CPU 时间片,无法执行完临界区,也就无法释放锁;
- H 继续自旋,L 继续得不到调度……死循环。
在单核设备上这是必死的;多核设备上如果恰好没有空闲核心给 L,同样会卡住。
两种形态的对比
| 三线程模型 | 自旋锁模型 | |
|---|---|---|
| 参与线程 | L、M、H 三条 | L、H 两条即可 |
| 阻塞方式 | H 睡眠等待,被 M 反复抢占 | H 忙等自旋,直接抢死 L 的 CPU |
| 根因 | 调度策略没有考虑锁的持有关系 | 等待方活跃,与持有方争抢 CPU |
| 是否所有锁都有 | 是,互斥锁同样会发生 | 仅自旋锁 |
| 严重程度 | H 被延迟,时间无上限 | 通常直接死循环卡死 |
| 能否修复 | 能,优先级继承 | 不能(纯用户态无法通知内核) |
关键区别在于:自旋锁的等待方是“活跃”的,它在跟持有方抢 CPU。 而互斥锁的等待方是睡眠的,不参与 CPU 竞争,反而给了持有方执行的机会——所以互斥锁只会“被延迟”,自旋锁会“彻底卡死”。
一个常见误解要澄清:优先级反转不是自旋锁独有的问题。互斥锁同样会遇到三线程模型,只是它的后果较轻且可以通过优先级继承修复。所以“换成互斥锁就没有优先级反转”这个说法是错的,准确的说法是“互斥锁的优先级反转可以被修复”。
解决方案一:优先级继承
这是 iOS 实际采用的方案。核心思想:
当高优先级线程 H 等待低优先级线程 L 持有的锁时,系统临时把 L 的优先级提升到 H 的水平,让 L 尽快执行完并释放锁;释放后 L 恢复原优先级。
回到三线程模型:L 被提升到 H 的优先级后,M 就再也无法抢占 L 了,L 得以迅速跑完临界区并释放锁,H 随即获得锁。H 的等待时间重新变成有界的——最多就是一个临界区的长度。
它的实现前提是内核必须知道“谁持有这把锁”。因此这类锁必须:
- 在锁结构里记录 owner 线程 ID(
os_unfair_lock那 4 个字节存的就是 owner token); - 加解锁走内核可见的路径(Darwin 上是 ulock 系统调用配合 turnstile 机制)。
纯用户态的自旋锁两条都做不到——它只是一个普通的整型变量,内核完全不知道谁在等谁。这就是 OSSpinLock 无法被修复、只能被废弃的根本原因。
turnstile 是 Darwin 内核里专门用于传递优先级的数据结构,它维护了一条“谁在等谁”的关系链,可以做传递性提升:如果 H 等 M、M 又等 L,那么 L 会被一路提升到 H 的优先级。前面讲
dispatch_sync抢不到 drain lock 时“把等待者 QoS 推给持有者”,以及dispatch_once慢路径的优先级继承,用的都是这同一套机制。
解决方案二:优先级天花板
这是教材里的另一种经典方案,iOS 上不常用,但值得知道:
给每把锁预先设定一个天花板优先级,其值等于所有可能获取这把锁的线程中的最高优先级。任何线程一旦拿到这把锁,其优先级立即被提升到天花板。
两者的差别:
| 优先级继承 | 优先级天花板 | |
|---|---|---|
| 提升时机 | 有高优先级线程来等待时才提升 | 一拿到锁就立即提升 |
| 提升幅度 | 提升到实际等待者的最高优先级 | 提升到预设的天花板 |
| 前提条件 | 无 | 必须预先知道所有会用这把锁的线程优先级 |
| 开销 | 仅在发生竞争时 | 每次加锁都有 |
| 额外收益 | 无 | 可以预防死锁(同一线程无法再被更高优先级抢占) |
天花板的问题在于它需要静态分析出所有使用者,这在动态的 App 环境里几乎不可行,所以 iOS 采用的是优先级继承。实时操作系统(RTOS)里天花板更常见,因为那里的任务集合是固定且已知的。
iOS 上的优先级反转有多容易发生
自从引入 QoS 之后,这个问题在 iOS 上其实比很多人想象的更常见:
// 典型的危险代码
dispatch_async(dispatch_get_global_queue(QOS_CLASS_BACKGROUND, 0), ^{
    [lock lock];
    [self doSomethingSlow];      // 后台低优先级线程持有锁
    [lock unlock];
});

// 主线程(QOS_CLASS_USER_INTERACTIVE)
[lock lock];                     // 主线程被后台线程阻塞了
[self readData];
[lock unlock];
QOS_CLASS_BACKGROUND 和主线程的优先级差距非常大,而 background 级别的线程在系统繁忙或低电量模式下可能被大幅限流甚至暂停调度。此时主线程就会被拖住,表现为界面卡顿甚至看门狗超时崩溃。
好在如果你用的是 os_unfair_lock、pthread_mutex 或 @synchronized,系统会自动做优先级继承,缓解这个问题。但如果用的是 dispatch_semaphore(没有 owner,无法做优先级继承),就没有这层保护。
如何避免
- 别用
OSSpinLock,它已经废弃。需要高性能锁用os_unfair_lock。 - 跨 QoS 共享锁时要格外小心。理想情况下,同一把锁应该只被优先级相近的线程使用。
- 不要在
QOS_CLASS_BACKGROUND的任务里持有主线程也会用的锁——这是最容易出事的组合。 - 缩短临界区。临界区越短,反转窗口越小。绝不在持锁期间做 I/O、网络请求或调用外部不可控的回调。
- 高竞争场景慎用
dispatch_semaphore当互斥锁,它没有优先级继承。需要互斥优先选os_unfair_lock。 - 优先考虑无锁方案:用串行队列替代锁,GCD 自己会处理 QoS 传递(
dispatch_sync会把调用者的 QoS 推给队列)。
OSSpinLock 的死亡
理解了优先级反转,就能解释 iOS 锁相关面试最经典的一道题了。
OSSpinLock 曾经是 iOS 上最快的锁,很多知名库(早期的 YYKit、SDWebImage 等)都在用。2016 年,它被曝出存在严重问题,Apple 将其标记为废弃:
// OSSpinLock 现在的声明
__OSX_AVAILABLE_BUT_DEPRECATED(...)原因就是上面的形态二:它是纯用户态的自旋锁,等待方忙等抢 CPU,而且因为内核完全不知道谁持有这把锁,无法通过优先级继承修复。这是一个设计层面的死结,不是实现 bug,所以只能废弃。
Apple 给出的替代品是 os_unfair_lock,下一节详细讲。
os_unfair_lock:OSSpinLock 的替代者
Apple 给出的替代品是 os_unfair_lock(iOS 10 / macOS 10.12 引入):
#import <os/lock.h>

os_unfair_lock lock = OS_UNFAIR_LOCK_INIT;

os_unfair_lock_lock(&lock);
// 临界区
os_unfair_lock_unlock(&lock);
特性:
| 特性 | 说明 |
|---|---|
| 等待策略 | 不自旋,抢不到锁就让线程睡眠 |
| 优先级继承 | 支持。锁内记录 owner 线程,内核可做优先级捐赠 |
| 可重入 | 不支持。同一线程二次加锁会直接 crash(这正是“unfair”名字的由来之一) |
| 公平性 | 不保证。等待队列不是 FIFO,刚释放锁的线程可能立刻重新抢到——所谓 unfair |
| 性能 | 无竞争时接近自旋锁,是目前 iOS 上最快的通用锁 |
| 结构大小 | 只有 4 字节(一个 32 位 owner token) |
⚠️ 注意事项:
os_unfair_lock是结构体(值类型),不是对象。在 Swift 中直接用会有坑(Swift 可能复制它),必须用UnsafeMutablePointer分配,或改用NSLock/OSAllocatedUnfairLock(iOS 16+)。- 不可重入。递归调用需求请用
NSRecursiveLock或pthread_mutex的 recursive 类型。
面试标准答法:OSSpinLock 因优先级反转被废弃,替代品是 os_unfair_lock,区别在于前者忙等自旋、无法解决反转,后者让等待线程休眠并支持优先级继承。
pthread_mutex:万锁之源
pthread_mutex 是 POSIX 标准的互斥锁,Foundation 里几乎所有锁最终都建立在它或类似机制之上。
pthread_mutex_t mutex;
pthread_mutex_init(&mutex, NULL);

pthread_mutex_lock(&mutex);
// 临界区
pthread_mutex_unlock(&mutex);

pthread_mutex_destroy(&mutex);   // 必须销毁
它的强大之处在于可以通过 attr 配置类型:
| 类型 | 行为 |
|---|---|
PTHREAD_MUTEX_NORMAL |
默认。不检测死锁,同一线程重复加锁会死锁 |
PTHREAD_MUTEX_ERRORCHECK |
检错型。重复加锁返回错误而非死锁,便于调试 |
PTHREAD_MUTEX_RECURSIVE |
递归锁。同一线程可重复加锁,内部计数,需对应次数解锁 |
PTHREAD_MUTEX_DEFAULT |
等同 NORMAL |
配置递归锁:
pthread_mutexattr_t attr;
pthread_mutexattr_init(&attr);
pthread_mutexattr_settype(&attr, PTHREAD_MUTEX_RECURSIVE);
pthread_mutex_init(&mutex, &attr);
pthread_mutexattr_destroy(&attr);
Foundation 各锁的实现关系
| Foundation 类 | 底层实现 |
|---|---|
NSLock |
pthread_mutex(NORMAL 类型)的 ObjC 封装 |
NSRecursiveLock |
pthread_mutex(RECURSIVE 类型)的封装 |
NSCondition |
pthread_mutex + pthread_cond 的封装 |
NSConditionLock |
基于 NSCondition 再封一层整数条件 |
所以 NSLock 比 pthread_mutex 慢——多了一层 ObjC 消息发送的开销。而 NSConditionLock 是封装最厚的,性能也最差。
条件变量的原理
NSCondition 封装的 pthread_cond 值得单独说一下,因为“为什么 wait 要写在 while 循环里”是高频追问。
pthread_cond_wait 做了三件原子完成的事:
- 释放传入的互斥锁;
- 让当前线程睡眠,加入条件变量的等待队列;
- 被唤醒后重新获取互斥锁,然后返回。
第 1 步和第 2 步必须原子完成,否则会出现“刚释放锁、还没睡下,signal 就来了”的丢失唤醒问题。
而必须用 while 而不是 if,前面章节提到了两个原因,这里补充底层解释:
- 虚假唤醒(spurious wakeup):POSIX 标准明确允许
pthread_cond_wait在没有 signal 的情况下返回。这不是 bug,而是为了让实现能在信号中断等场景下简化处理。 - 唤醒与重新加锁之间的窗口:第 3 步“重新获取锁”可能需要排队。在排队期间,另一个线程可能抢先拿到锁并把条件改回不满足的状态。
两个原因都指向同一个结论:醒来之后必须重新检查条件,所以只能用 while。
pthread_rwlock:读写锁
前面“线程同步”一章的锁类型表里提到过读写锁,并且引用了 Apple 文档的一句话:“系统仅支持使用 POSIX 线程实现读写锁”。Foundation 确实没有提供对应的类,所以要用读写锁只能直接调 pthread_rwlock。
为什么需要读写锁
普通互斥锁对“读”和“写”一视同仁:两个线程同时读一份数据也要排队。但读操作之间本来就不冲突——没有人修改数据时,多少个线程同时读都是安全的。
读写锁(也叫共享-互斥锁)把锁分成两种模式:
| 模式 | 语义 |
|---|---|
| 读锁(共享锁) | 可以被多个线程同时持有 |
| 写锁(互斥锁) | 同时只能被一个线程持有,且与所有读锁互斥 |
规则很简单:读读并行,读写互斥,写写互斥。
适用场景是读远多于写的共享数据(配置表、缓存等)。如果读写比例接近,读写锁反而不如普通互斥锁——它的内部状态维护比 mutex 复杂,开销更大。
用法
#import <pthread.h>

pthread_rwlock_t rwlock;
pthread_rwlock_init(&rwlock, NULL);

// 读操作
pthread_rwlock_rdlock(&rwlock);
id value = _dict[key];
pthread_rwlock_unlock(&rwlock);

// 写操作
pthread_rwlock_wrlock(&rwlock);
_dict[key] = obj;
pthread_rwlock_unlock(&rwlock);

pthread_rwlock_destroy(&rwlock);   // 必须销毁
完整 API:
| 函数 | 说明 |
|---|---|
pthread_rwlock_rdlock |
获取读锁,被写锁占用时阻塞 |
pthread_rwlock_wrlock |
获取写锁,被任何锁占用时阻塞 |
pthread_rwlock_tryrdlock |
尝试获取读锁,失败立即返回错误码 |
pthread_rwlock_trywrlock |
尝试获取写锁,失败立即返回错误码 |
pthread_rwlock_unlock |
读锁写锁共用同一个解锁函数 |
pthread_rwlock_destroy |
销毁 |
注意最后一点:读锁和写锁用同一个 unlock,锁内部自己知道当前是什么模式。
写者饥饿问题
读写锁有一个经典缺陷:如果读线程源源不断地到来,写线程可能永远等不到机会——这就是前面“锁带来的问题”一节讲过的资源匮乏(饥饿)。
解决办法是让实现“偏向写者”:一旦有写者在等待,就阻塞后续新到的读者,让存量读者跑完后写者立即进入。POSIX 标准没有规定必须这样做,具体行为取决于实现。Darwin 的 pthread_rwlock 在有写者等待时会阻塞新读者,因此不容易出现写者饥饿,但这属于实现细节,不应该依赖。
与 dispatch_barrier 的对比
前面 GCD 章节讲过“并发队列 + dispatch_barrier_async”实现多读单写。它和 pthread_rwlock 解决的是同一个问题:
| 维度 | pthread_rwlock |
并发队列 + barrier |
|---|---|---|
| 写操作是否阻塞调用方 | 是,wrlock 会等 |
否,barrier_async 立即返回 |
| 读操作 | rdlock 后同步读 |
dispatch_sync 同步读 |
| 死锁风险 | 有(嵌套加锁、忘记 unlock) | 较低,但 sync 用错队列仍会死 |
| 心智负担 | 需手动配对 lock/unlock | 由 GCD 管理 |
| 性能 | 略好(无队列调度开销) | 略差,但差距在多数场景可忽略 |
实际工程中优先选 barrier 方案——写操作异步不阻塞调用方是很大的优势,而且不用担心忘记解锁。pthread_rwlock 适合对性能极度敏感、或者需要在纯 C/C++ 代码里使用的场景。
dispatch_semaphore 当锁用
信号量本身是用来控制并发数量的,但把初始值设为 1,它就是一把互斥锁:
dispatch_semaphore_t lock = dispatch_semaphore_create(1);

dispatch_semaphore_wait(lock, DISPATCH_TIME_FOREVER);   // 相当于 lock
// 临界区
dispatch_semaphore_signal(lock); // 相当于 unlock它的实现原理在上一章讲过:无竞争时只是两条原子指令,完全不进内核,所以性能非常好,接近 os_unfair_lock。
独有的优势:支持超时
这是它区别于其他所有锁的最大特点——wait 的第二个参数可以设置超时:
// 最多等 2 秒,超时返回非 0
long result = dispatch_semaphore_wait(lock,
    dispatch_time(DISPATCH_TIME_NOW, (int64_t)(2.0 * NSEC_PER_SEC)));

if (result != 0) {
    // 超时了,没拿到锁,可以选择放弃或重试
    return;
}
// 拿到锁
// ...
dispatch_semaphore_signal(lock);前面“锁带来的问题”一节提到的四种死锁应对手段里,“设置等待超时”这一条在 iOS 上最直接的实现方式就是它。NSLock 虽然也有 lockBeforeDate:,但性能差得多。
需要注意的点
| 注意点 | 说明 |
|---|---|
| 不可重入 | 同一线程二次 wait 会把自己锁死(计数已归零),行为和 os_unfair_lock 一样 |
| 没有 owner 概念 | 任何线程都可以 signal,甚至从来没 wait 过的线程也行。这既是灵活性也是隐患 |
| 无优先级继承 | 因为没有 owner,内核不知道该给谁提升优先级。高竞争 + 跨 QoS 场景下有优先级反转风险 |
| 初始值不能为负 | create 传负数返回 NULL |
| 销毁前必须归位 | 信号量销毁时若当前值小于初始值(还有人在等),会直接 crash |
最后一条尤其容易踩:
dispatch_semaphore_t sema = dispatch_semaphore_create(0);
dispatch_async(queue, ^{
    dispatch_semaphore_wait(sema, DISPATCH_TIME_FOREVER);
});
// sema 在这里被释放 → 有线程还在等 → crash
和 os_unfair_lock 怎么选
两者性能接近,选择标准很明确:
- 需要超时 →
dispatch_semaphore - 需要限制并发数(不只是互斥) →
dispatch_semaphore - 纯互斥、且可能出现高优先级线程等低优先级线程 →
os_unfair_lock(有优先级继承) - 需要 owner 校验、防止误解锁 →
os_unfair_lock
@synchronized 的源码剖析
这是最值得深挖的一个,因为实现完全开源,就在 Apple 的 objc4 项目的 runtime/objc-sync.mm 里。下面基于 objc4-951.7 版本(截至本文写作时的最新公开 drop)。
编译器做了什么
@synchronized(obj) {
    // 临界区
}
编译器会把它展开成(用 clang -rewrite-objc 可以看到):
objc_sync_enter(obj);
@try {
    // 临界区
} @finally {
    objc_sync_exit(obj);
}关键点:编译器自动生成了异常处理,所以临界区里即使抛出异常或提前 return,锁也一定会被释放。这就是前面提到的“@synchronized 隐式提供异常安全,而 NSLock 没有”的具体含义。
核心数据结构
typedef struct alignas(CacheLineSize) SyncData {
    struct SyncData* nextData;        // 单向链表,指向下一个
    DisguisedPtr<objc_object> object; // 被加锁的对象(伪装指针,避免被泄漏检测误判)
    SyncKind kind;
    int32_t threadCount;              // 有多少条【线程】在用这个 block
    recursive_mutex_t mutex;          // 真正的锁
} SyncData;
每个被 @synchronized 的对象,对应一个 SyncData 节点,里面装着一把递归锁。
注意 alignas(CacheLineSize):让每个 SyncData 独占一条缓存行,避免多核下的伪共享(false sharing)——不同核心操作相邻的锁时互相导致缓存失效。这是个很典型的高性能代码细节。
递归锁是什么实现的?
这一点很多老文章写错了。在当前版本中:
using recursive_mutex_t = objc_recursive_lock_t;追下去会发现,在 Darwin 平台上它包装的是:
class objc_recursive_lock_base_t : nocopy_t {
    os_unfair_recursive_lock lock_;   // 不是 pthread_mutex!
    ...
};
底层是 os_unfair_recursive_lock,不是 pthread_mutex。 早期版本(objc4-750 左右)确实用的是 pthread_mutex_t 的 recursive 类型,后来 Apple 换成了性能更好、支持优先级继承的 unfair lock 变体。
面试时如果说“@synchronized 底层是 pthread_mutex 递归锁”,遇到读过新版源码的面试官会被纠正。准确说法是:底层是一把递归互斥锁,当前实现为 os_unfair_recursive_lock。
怎么根据对象找到锁:StripedMap
关键问题来了:给一个任意对象,怎么快速找到它对应的 SyncData?
答案是一个全局的分离锁哈希表:
static objc::ExplicitInit<StripedMap<SyncList>> sDataLists;

#define LOCK_FOR_OBJ(obj) sDataLists.get()[obj]._lock
#define LIST_FOR_OBJ(obj) sDataLists.get()[obj]._data
StripedMap 是 objc4 里一个通用的**锁条带化(lock striping)**容器(SideTable 也用它):
template<typename T>
class StripedMap {
#if TARGET_OS_IPHONE && !TARGET_OS_SIMULATOR
    enum { StripeCount = 8 };    // 真机:8 条
#else
    enum { StripeCount = 64 };   // Mac / 模拟器:64 条
#endif

    struct PaddedT {
        T value alignas(CacheLineSize);  // 每条独占缓存行
    };
    PaddedT array[StripeCount];

    static unsigned int indexForPointer(const void *p) {
        uintptr_t addr = reinterpret_cast<uintptr_t>(p);
        return ((addr >> 4) ^ (addr >> 9)) % StripeCount;
    }
    ...
};设计思路:用对象地址哈希到若干条独立的链表上,每条链表有自己的锁。 这样操作不同对象时大概率落在不同条带,不会互相竞争——比用一把全局锁保护整张表要好得多。
注意真机只有 8 条(Mac 是 64 条),因为移动端更在意内存占用。这也意味着真机上不同对象的 @synchronized 撞到同一条带的概率并不低,这是 @synchronized 性能不佳的原因之一。
每条条带是这样一个结构:
struct SyncList {
    SyncData *_data;    // SyncData 单向链表
    spinlock_t _lock;   // 保护这条链表(实际是 os_unfair_lock,名字是历史遗留)
};
顺带一提,objc4 里的
spinlock_t不是自旋锁,它是using spinlock_t = objc_lock_t;,底层就是os_unfair_lock。名字是OSSpinLock时代留下的,Apple 换了实现但没改名。这是个容易被绕进去的细节。
两级线程缓存
如果每次 @synchronized 都要去哈希表里遍历链表,开销还是太大。objc4 做了两级缓存:
第一级:TLS 快速缓存(只能存一个对象)
static tls_direct_fast(SyncData *, tls_key::sync_data) syncData;
static tls_direct_fast(uintptr_t, tls_key::sync_count) syncLockCount;
用两个固定的 pthread TLS key 直接存一个 SyncData 指针和它的加锁次数。绝大多数线程在同一时刻只在同步一个对象,这一级就够了,完全不需要 malloc。
第二级:per-thread 的 SyncCache 数组
typedef struct SyncCache {
    unsigned int allocated;
    unsigned int used;
    SyncCacheItem list[0];   // 柔性数组,每项是 { SyncData*, lockCount }
} SyncCache;
当一条线程同时嵌套同步多个不同对象时,才会 malloc 这个数组(初始 4 项,不够就翻倍)。
注意 lockCount 是这条线程对该对象的加锁次数,而 SyncData.threadCount 是有多少条线程在用它。两个计数各司其职:前者实现递归,后者决定 SyncData 节点能否被回收复用。
id2data:完整查找流程
所有逻辑集中在 id2data(id object, SyncKind kind, enum usage why),why 取值 ACQUIRE / RELEASE / CHECK。流程:
① 查 TLS 快速缓存 —— 命中?改 lockCount,直接返回(最快路径)
      ↓ 未命中
② 查线程的 SyncCache 数组 —— 命中?改 lockCount,返回
      ↓ 未命中
③ 对象地址哈希 → 找到对应条带 → 加条带锁
      ↓
④ 遍历该条带的 SyncData 链表找匹配的对象
      ├─ 找到:threadCount 原子 +1,存入线程缓存,返回
      └─ 没找到:
           - 如果是 RELEASE / CHECK → 返回 NULL(说明解了一把没加过的锁)
           - 如果是 ACQUIRE → 复用一个 threadCount == 0 的空闲节点,
             或 malloc 一个新 SyncData 头插到链表,threadCount = 1
然后 objc_sync_enter 拿到 SyncData 后调 data->mutex.lock(),objc_sync_exit 调 data->mutex.tryUnlock()。
由此可以回答的问题
1. @synchronized 为什么慢?
- 哈希查找 + 链表遍历(未命中缓存时);
- 条带锁本身也是一次加解锁;
- 缓存不够时要 malloc;
- 递归锁比普通锁开销大;
- 真机只有 8 条条带,不同对象容易互相竞争;
- 加上
@try/@finally异常处理的开销。
它是常用锁里性能最差的之一,只在低频场景使用。
2. @synchronized(nil) 会怎样?
什么也不做,也不会崩溃,等于没加锁。源码里:
if (obj) {
    SyncData* data = id2data(obj, kind, ACQUIRE);
    data->mutex.lock();
} else {
    // @synchronized(nil) does nothing
    objc_sync_nil();   // 这是个空函数,专供下断点调试
    ...
}这是个巨大的隐患:如果锁对象是一个可能为 nil 的变量,你的临界区会在无声无息中失去保护。可以用 OBJC_DEBUG_NIL_SYNC 环境变量让它打印警告。这也是面试爱问的点。
3. 锁对象为什么必须是“不变”的?
// 错误示范
@synchronized(self.array) {
    self.array = [NSMutableArray new];   // 换了锁对象!
}因为查找是按对象地址哈希的。换了对象,后续线程算出的是另一个 SyncData,锁就完全失效了。锁对象要选一个生命周期内地址稳定的对象,通常用 self 或一个专门的私有实例变量。
4. 为什么 @synchronized(self) 不推荐?
self 是外部可见的。如果外部代码也对同一个对象 @synchronized,就会和你内部的锁互相干扰,可能造成意外的性能问题甚至死锁。这也是前面“会议室”比喻想说明的问题——锁该选谁,看的是保护哪份资源,而不是代码写在哪里。推荐做法:
@interface MyClass () {
    NSObject *_lockToken;   // 专用锁对象,外部不可见
}
@end
5. 它是递归锁,所以下面这段不会死锁:
@synchronized(obj) {
    @synchronized(obj) {   // 同一线程,安全
        // ...
    }
}
atomic 属性的实现
前面说过 atomic 不等于线程安全,现在看它到底做了什么。实现在 objc4 的 runtime/objc-accessors.mm:
objc::ExplicitInit<StripedMap<spinlock_t>> PropertyLocks;

id objc_getProperty(id self, SEL _cmd, ptrdiff_t offset, BOOL atomic) {
    if (offset == 0) return object_getClass(self);

    id *slot = (id*) ((char*)self + offset);
    if (!atomic) return *slot;        // nonatomic:直接读,零开销

    // atomic:按【属性地址】取一把条带锁
    spinlock_t& slotlock = PropertyLocks.get()[slot];
    slotlock.lock();
    id value = objc_retain(*slot);
    slotlock.unlock();

    // 出锁之后再 autorelease,减少持锁时间
    return objc_autoreleaseReturnAutoreleased(value);
}
几个要点:
- 又是
StripedMap。和@synchronized用的是同一套条带化技术,但那是一张独立的表(PropertyLocks)。所以真机上也只有 8 条——不同对象的不同 atomic 属性可能共用一把锁。 nonatomic是真的零开销,直接读写内存;atomic每次读写都要加解锁。- 注意
objc_retain在锁内、autorelease在锁外——这是刻意的优化,尽量缩短持锁时间。 - 这也解释了为什么
atomic只能保证单次存取的完整性:锁的粒度就是一次 getter / setter 调用,调用返回后锁就释放了。self.count = self.count + 1是两次独立的加锁调用,中间完全没有保护。
Setter 同理,在 reallySetProperty 中加锁完成“保存旧值 → 写入新值”,出锁后再 release 旧值。
各类锁的性能与选型
性能排序
大致的性能排序(无竞争情况下,从快到慢):
os_unfair_lock  ≈  dispatch_semaphore
      >  pthread_mutex  ≈  pthread_rwlock
      >  NSLock  ≈  NSCondition
      >  NSRecursiveLock  >  NSConditionLock
      >  @synchronized
注意 pthread_rwlock 的位置只是无竞争时的单次加解锁开销。它的价值不在单次开销,而在于读多写少时允许多个读者并行——这个收益会随着读并发量放大,远超它比 mutex 多出的那点状态维护成本。选它是为了并行度,不是为了单次速度。
@synchronized 通常是最慢的,但它的差距在低频场景下完全可以忽略——不要为了几十纳秒放弃代码可读性和异常安全。
注意:网上流传的那张著名性能对比图出自 ibireme 的《不再安全的 OSSpinLock》,测试于 2016 年,其中
OSSpinLock排第一。现在OSSpinLock已废弃,且各锁实现都有更新,那张图的具体数值已不适用,但相对排序大体仍成立。
选型建议
| 场景 | 推荐 |
|---|---|
| 普通互斥,性能敏感 | os_unfair_lock(Swift 用 OSAllocatedUnfairLock,iOS 16+) |
| 普通互斥,代码简洁优先 | NSLock |
| 需要递归加锁 | NSRecursiveLock |
| 需要等待某个条件 | NSCondition |
| 限制并发数量 | dispatch_semaphore |
| 需要加锁超时 | dispatch_semaphore(唯一的高性能选择) |
| 保护共享资源、避免锁 | 串行队列 + async(无锁方案,往往是最优解) |
| 多读单写 | 并发队列 + dispatch_barrier_async,或 pthread_rwlock |
| 一次性初始化 | dispatch_once |
| 低频、需要异常安全 | @synchronized |
最后一条选型原则最重要:在 iOS 上,很多需要加锁的场景其实可以用串行队列替代。把所有对共享资源的访问都 dispatch_async 到同一条串行队列上,天然互斥、没有死锁风险、也不会有优先级反转。代价是失去了同步返回值的能力(需要返回值时用 dispatch_sync,就退化成了一把锁)。
锁的面试题
Q1:什么是优先级反转?怎么解决?
优先级反转指高优先级线程被低优先级线程间接阻塞,导致实际执行顺序与优先级设定相反。
经典的三线程模型:低优先级线程 L 持有锁并正在执行临界区;高优先级线程 H 需要这把锁被阻塞;此时中优先级线程 M(它不需要这把锁)就绪,因为优先级高于 L 而抢占 CPU。结果 L 一直得不到调度、无法释放锁,H 只能等 M 和 L 都跑完。执行顺序变成 M → L → H,与优先级完全相反。
之所以称为“无界优先级反转”,是因为这样的 M 可以有很多个、可以运行任意久,H 被延迟的时间没有上限。1997 年火星探路者号频繁重启的事故就是这个模型的真实案例。
两种解决方案:
- 优先级继承(iOS 采用)——H 来等待时,临时把 L 的优先级提升到 H 的水平,L 释放锁后恢复。前提是内核知道谁持有锁,所以锁结构必须记录 owner 线程 ID,Darwin 上通过 ulock + turnstile 实现,且支持传递性提升。
- 优先级天花板——给每把锁预设一个天花板优先级(所有可能使用者中的最高值),线程一拿到锁就提升到该值。需要静态知道所有使用者,在动态的 App 环境里不实用,多见于实时操作系统。
iOS 上的实际风险:跨 QoS 共享锁最危险,尤其是 QOS_CLASS_BACKGROUND 的任务持有主线程也要用的锁——background 线程在系统繁忙或低电量模式下可能被大幅限流,会把主线程一起拖死。用 os_unfair_lock / pthread_mutex / @synchronized 有优先级继承保护,用 dispatch_semaphore 则没有(它没有 owner 概念)。
Q2:`OSSpinLock` 为什么被废弃?
因为优先级反转。低优先级线程持有自旋锁时,高优先级线程会一直自旋抢占 CPU,导致低优先级线程得不到时间片、无法执行完临界区释放锁,形成死循环。
自旋锁的等待方是活跃的、要跟持有方抢 CPU,而纯用户态实现又无法让内核知道“谁持有这把锁”,因此无法做优先级继承——这个缺陷不可修复,只能废弃。
替代品是 os_unfair_lock:等待线程休眠不占 CPU,锁内记录 owner 线程,内核可做优先级捐赠。
Q3:自旋锁和互斥锁的区别?各自适用场景?
区别在抢不到锁时的等待策略:自旋锁忙等(不释放 CPU),互斥锁阻塞(线程睡眠,让出 CPU)。
- 自旋锁适合临界区极短的场景(短于一次上下文切换的开销,约几微秒),避免切换成本;
- 互斥锁适合临界区较长或竞争激烈的场景。
现代实现基本都是混合策略:先自旋一小段,失败后再睡眠。
Q4:`@synchronized` 的底层实现是什么?
编译器展开为 objc_sync_enter / objc_sync_exit,并自动包上 @try/@finally 保证异常安全。
实现在 objc4 的 objc-sync.mm:每个加锁对象对应一个 SyncData 结构,内含一把递归互斥锁(当前版本为 os_unfair_recursive_lock)。通过 StripedMap 按对象地址哈希到若干条带(真机 8 条、Mac 64 条),每条带一个链表加一把条带锁。同时有两级线程缓存(TLS 单槽 + per-thread 数组)避免重复哈希查找。
它慢的原因:哈希查找、链表遍历、条带锁本身的开销、可能的 malloc、递归锁开销,以及异常处理开销。
Q5:`@synchronized(nil)` 会发生什么?
什么都不会发生,锁完全失效,且不报错。 源码里对 nil 直接跳过加锁逻辑。这是个隐蔽的重大隐患——锁对象是可能为 nil 的变量时,临界区会静默失去保护。
Q6:`@synchronized` 的锁对象应该怎么选?
三条原则:
- 地址必须稳定:查找按对象地址哈希,换了对象等于换了锁;
- 不能为 nil;
- 不要用
self:self外部可见,外部代码对同一对象加锁会与内部逻辑互相干扰。推荐用一个私有的NSObject实例变量。
更根本的原则:锁选谁,取决于要保护哪份资源,而不是代码写在哪个方法里。
Q7:`NSLock` 和 `@synchronized` 的区别?
| 维度 | @synchronized |
NSLock |
|---|---|---|
| 创建方式 | 隐式,按对象自动查找/创建 | 显式创建对象 |
| 可重入 | 是(递归锁) | 否(二次 lock 会死锁) |
| 异常安全 | 是(编译器生成 @finally) |
否,需手动 @try/@finally |
| 性能 | 较慢 | 较快 |
| nil 处理 | 静默失效 | 无此问题 |
Q8:`NSCondition` 里为什么必须用 `while` 而不是 `if`?
两个原因:
- 虚假唤醒:POSIX 标准明确允许
pthread_cond_wait在没有 signal 时返回; - 重新加锁的窗口:被唤醒到重新拿到锁之间,其他线程可能抢先修改条件。
两者都要求“醒来后重新检查条件”,所以必须用 while 循环包裹 wait。
Q9:`atomic` 是怎么实现的?它能保证线程安全吗?
实现在 objc-accessors.mm:用一张全局的 StripedMap<spinlock_t>(PropertyLocks),按属性的内存地址哈希取锁,在 getter / setter 内部加解锁。nonatomic 则直接读写内存,零开销。
不能保证线程安全。锁的粒度只有单次 getter / setter 调用,self.count++ 这种“读-改-写”是两次独立调用,中间毫无保护。对于容器类属性,atomic 保护的是指针本身,容器内容的修改完全不在保护范围内。
Q10:什么是读写锁?iOS 上怎么实现多读单写?
读写锁把锁分为共享的读锁和互斥的写锁,规则是读读并行、读写互斥、写写互斥,适合读远多于写的数据。
iOS 上一共有四种实现方式:
1. 并发队列 + dispatch_barrier_async(最推荐)
读用 dispatch_sync(需要同步返回值),写用 dispatch_barrier_async(不阻塞调用方)。barrier 保证写操作独占队列。
- (id)objectForKey:(NSString *)key {
    __block id result = nil;
    dispatch_sync(_queue, ^{ result = _dict[key]; });
    return result;
}

- (void)setObject:(id)obj forKey:(NSString *)key {
    dispatch_barrier_async(_queue, ^{ _dict[key] = obj; });
}
注意 barrier 必须用自建的并发队列,全局队列上会降级为普通 async。
2. pthread_rwlock
Foundation 没有封装读写锁,只能直接用 POSIX API。rdlock / wrlock 分别加读写锁,两者共用同一个 unlock。
3. NSLock + 条件控制(手动实现)
用一把 NSLock 保护一个“当前读者数量”计数器,自己实现读写锁的语义:第一个读者加写锁、最后一个读者解写锁,写者直接抢写锁。这是教科书式的实现方式,实际项目中很少手写,但面试可能要求描述思路。
4. NSCondition
用条件变量维护读者数和写者标志:读者在“有写者正在写”时 wait,写者在“有读者或写者”时 wait,操作完成后 broadcast 唤醒。相比第 3 种更灵活,可以精细控制读优先、写优先或读写公平三种策略。
选型:日常首选第 1 种——写操作异步不阻塞调用方,不用担心忘记解锁,心智负担最小。需要在纯 C/C++ 代码里用、或对性能极度敏感时选第 2 种。第 3、4 种基本只在面试里出现。
读写策略与写者饥饿:读写锁有个经典缺陷——读者源源不断到来时写者可能一直等不到,这就是前面讲过的资源匮乏(饥饿)。据此可以把实现分成三类:
| 策略 | 行为 | 问题 |
|---|---|---|
| 读优先 | 只要有读者在读,后续读者可直接进入 | 写者饥饿 |
| 写优先 | 一旦有写者在等待,就阻塞后续新读者 | 读者可能饥饿,但通常可接受 |
| 读写公平 | 按到达顺序排队(FIFO) | 实现最复杂,牺牲部分读并发 |
POSIX 没有强制规定采用哪种,具体行为取决于实现。Darwin 的 pthread_rwlock 在有写者等待时会阻塞新读者(偏向写优先),因此不易出现写者饥饿——但这属于实现细节,不应该依赖。
Q11:`dispatch_semaphore` 当锁用,有什么优缺点?
初始值设为 1 就是一把互斥锁。
优点:
- 性能好,无竞争时只有两条原子指令,不进内核,接近
os_unfair_lock; - 唯一支持超时的高性能锁——
wait的第二个参数可以设置超时时间,拿不到就放弃,这是打破死锁的实用手段。
缺点:
- 不可重入,同一线程二次
wait会锁死自己; - 没有 owner 概念,任何线程都能
signal,容易误解锁; - 没有优先级继承——正因为没有 owner,内核不知道该给谁提优先级,所以高竞争、跨 QoS 的场景下存在优先级反转风险;
- 销毁时若还有线程在等待(当前值小于初始值)会直接 crash。
选型:需要超时或需要限流时用信号量;纯互斥且可能跨优先级竞争时用 os_unfair_lock。
Q12:什么是死锁?产生死锁的四个必要条件?
死锁指两个或多个线程互相等待对方持有的资源,导致全部无法推进。四个必要条件(缺一不可):
- 互斥:资源同时只能被一个线程占有;
- 持有并等待:线程持有资源的同时等待其他资源;
- 不可剥夺:资源只能由持有者主动释放;
- 循环等待:存在一个线程等待的环形链。
破坏任意一条即可避免死锁。工程上最常用的是破坏第 4 条——规定全局统一的加锁顺序,所有线程都按同样的顺序获取多把锁。
Q13:如何避免死锁?
- 统一加锁顺序,消除循环等待(最常用、最有效);
- 使用
tryLock+ 超时,拿不到就退避重试,而不是无限等待; - 减小锁的粒度和持有时间,临界区里绝不做耗时操作、绝不调用外部不可控的代码(尤其是回调);
- 避免嵌套加锁,实在需要就用递归锁;
- 优先考虑无锁方案——串行队列、不可变对象、线程封闭。
Q14(进阶):什么是锁条带化(lock striping)?objc4 里哪里用到了?
把一把全局大锁拆成 N 把小锁,按数据的哈希值决定用哪一把,从而让操作不同数据的线程大概率不互相竞争。这是一种典型的降低锁竞争手段。
objc4 里的 StripedMap 就是它的实现,至少用在三处:
@synchronized的SyncData表(objc-sync.mm)atomic属性锁PropertyLocks(objc-accessors.mm)SideTable(NSObject.mm)—— 存放溢出的引用计数和弱引用表
StripedMap 里每个条带都用 alignas(CacheLineSize) 独占一条缓存行,避免多核下的伪共享。真机 8 条、Mac / 模拟器 64 条。
Q15(进阶):锁除了互斥,还解决什么问题?
内存可见性和指令重排序。
加锁使用 acquire 语义(后续读写不能重排到加锁之前),解锁使用 release 语义(之前的读写不能重排到解锁之后)。这保证了“一个线程在解锁前的所有修改,另一个线程加锁后一定能看见”。
很多人只知道互斥,忽略了这一点。手写双重检查锁单例最常见的 bug——拿到一个“指针已赋值但对象未初始化完成”的半成品——正是因为缺少这个屏障。dispatch_once 用 acquire / release 精确解决了这个问题,这也是不该手写 DCL 的原因。
参考文献
书籍
- Keith Lee.《精通 Objective-C》
Apple 官方文档与视频
- Apple. Thread Safety Summary — Threading Programming Guide
- Apple. Modernizing Grand Central Dispatch Usage — WWDC 2017 Session 706
文章
- objc 中国.《并发编程:API 及挑战》
- onevcat(王巍).《常见的后台实践》
- ming1016(戴铭).《细说 GCD(Grand Central Dispatch)如何用》
- Stack Overflow. NSOperation vs Grand Central Dispatch
视频
- Bilibili.《iOS 开发 — GCD 大厂面试题详解》